셀카 퍼스널 컬러 진단 서비스를 만들고, 립 추천 서비스로 바꾸기까지
톤빛은 셀카 한 장으로 퍼스널 컬러를 가늠하고, 올리브영에서 잘 팔리는 립 196색 중 내 얼굴에 어울리는 립을 골라 발라 볼 수 있는 웹 서비스다. 10월 중순에 첫 버전을 올렸고, 3주 동안 진단 서비스에서 립 추천 서비스로 성격이 바뀌었다. “정확도를 올릴 수 없다는 걸 확인하고 나서 서비스를 어떻게 바꿨는가”가 이 프로젝트의 핵심이라, 그 과정과 판단 기준을 기록해 두려고 한다.
결과: 셀카를 올리면 내 톤이 확률과 함께 나온다. 내 얼굴에 바른 두 립 중 나은 쪽을 일곱 번 고르면, 196색 중 내 피부와 내 눈에 맞춘 순위가 나오고 바로 살 수 있다.
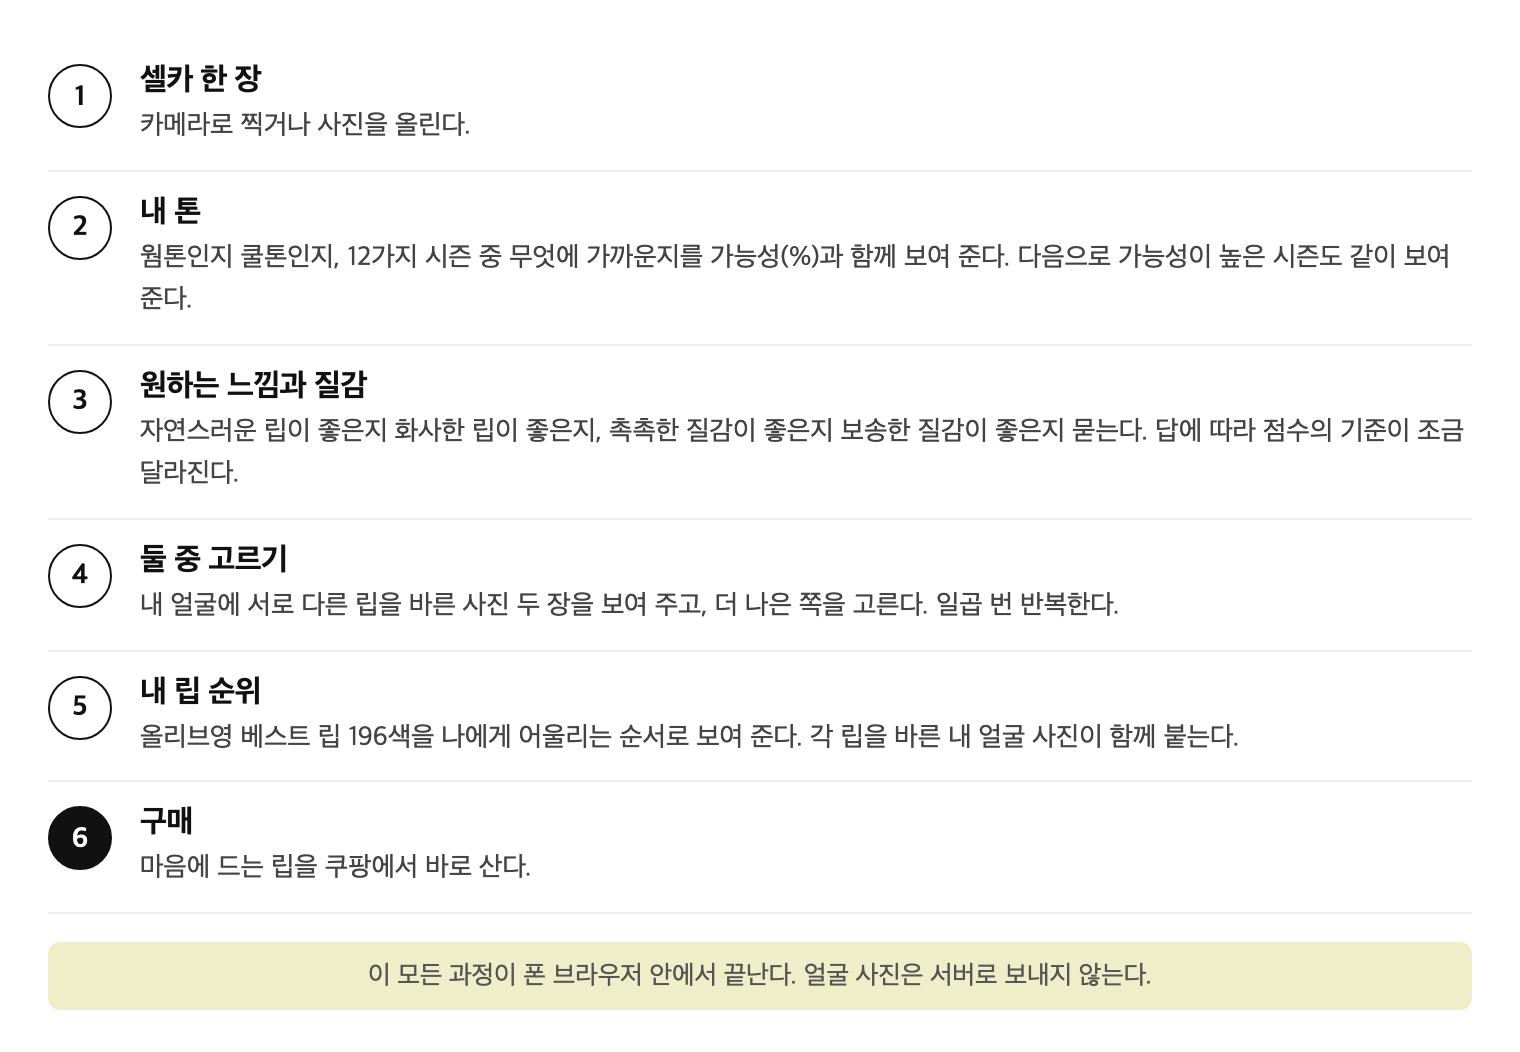
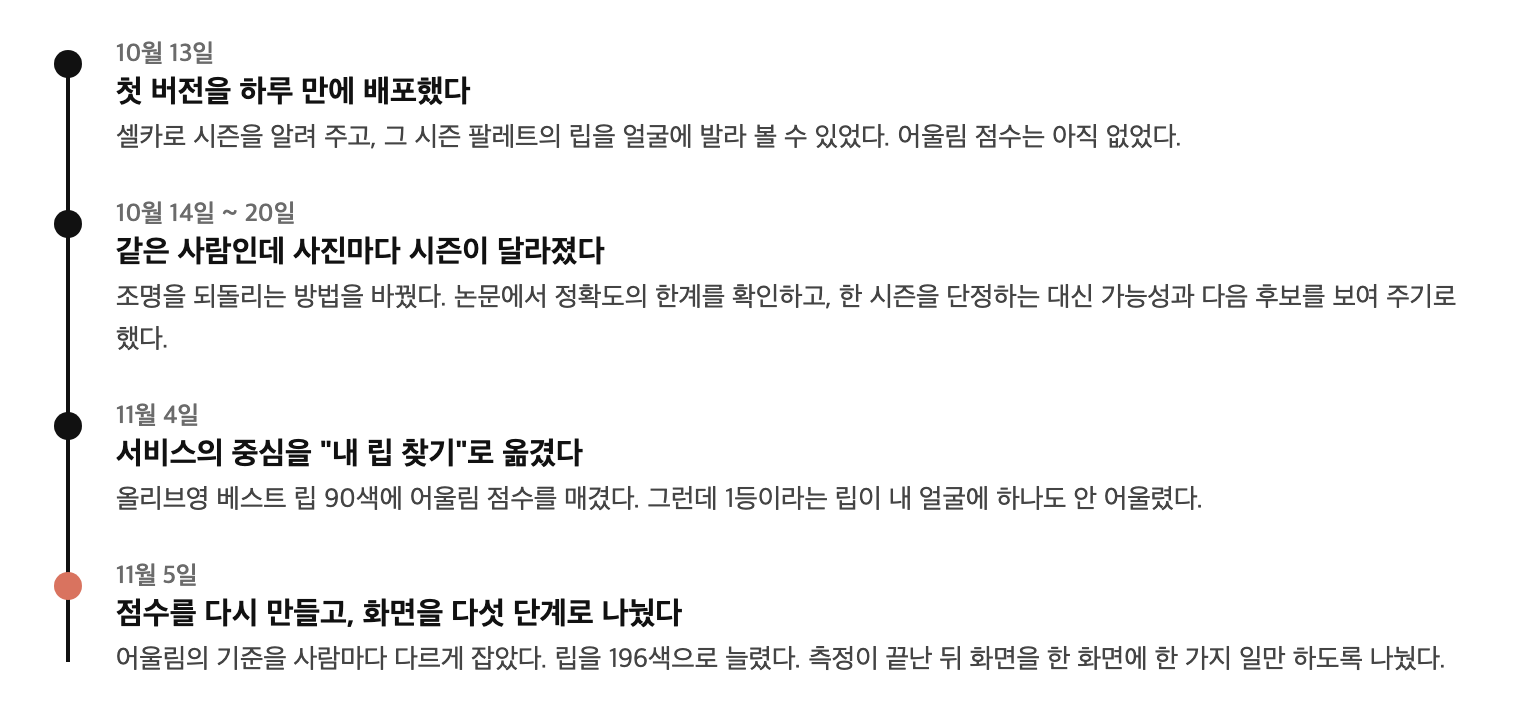
3주 동안 이런 순서로 바뀌었다. 아래 글도 같은 순서로 간다.
1. 왜 만들었나
뷰티와 유통에 관심이 있어서, 평소 궁금했던 퍼스널 컬러를 아이템으로 잡았다. 전문가 진단은 몇만 원에서 십만 원이 넘는다. 온라인 자가 진단은 설문이라 얼굴을 보지 않는다. 사진으로 봐 주는 앱은 사진을 서버로 올려야 한다. 그리고 어느 쪽이든 “당신은 여름 쿨입니다”에서 끝난다.
내가 만들고 싶었던 건 그 다음이었다. 진단이 “그래서 이 립을 사면 된다”까지 이어지는 서비스. 조건은 세 가지였다.
- 돈을 들이지 않는다. 서버 비용을 내지 않고, 광고 심사도 받지 않는다. 수익은 쿠팡 파트너스 링크로만 낸다.
- 할 수 있는 만큼 정확하게 진단한다.
- 진단에서 구매까지 한 흐름으로 이어지게 한다.
얼굴 인식 모델(MediaPipe)이 브라우저에서 돌아가니, 사진을 서버로 보내지 않는 구조로 갈 수 있었다.
2. 하루 만에 만든 첫 버전
아이디어를 내고 하루 만에 바이브 코딩으로 결과물을 만들어냈다. MVP를 따로 두지 않고 처음부터 서비스 모양을 갖췄다. 공유 카드, 쿠팡 링크, 보안 설정, 자동 테스트는 나중에 붙이면 구조를 다시 짜야 해서 첫날에 넣었다.
| 기능 | 첫날 범위 |
|---|---|
| 측정 | 셀카에서 얼굴을 찾아 볼과 이마 색을 읽고, 웜·쿨과 12가지 시즌 중 하나를 알려 준다 |
| 발라 보기 | 그 시즌에 맞는 립·블러셔 색을 사진 속 입술과 볼에 얹어 보여 준다 |
| 결과 페이지 | 톤마다 주소와 공유 썸네일이 있고, 제품 카드는 쿠팡으로 이어진다 |
| 보안·테스트 | 외부 연결을 막는 CSP, 가짜 카메라로 전체 흐름을 도는 Playwright 테스트 |
제품 색은 브랜드 설명을 보고 눈대중으로 적은 값이었고, 어울림 점수는 없었다. 시즌이 나오면 그 시즌 팔레트를 발라 보는 게 전부였다.
배포하고 폰으로 열어 보니 바로 문제가 보였다. 아이폰에서 모델이 안 뜨고, 아이패드가 데스크톱으로 잡히고, 색을 고르는 동안 사진이 화면 밖으로 밀려났다. 그날 저녁에만 일곱 개를 고쳤다. 데스크톱 브라우저에서만 확인하고 배포한 대가였다.
3. 진단이 사진마다 달랐다
며칠 써 보니 같은 사람인데 사진마다 다른 시즌이 나왔다. 전문가 진단을 받아 본 지인에게 돌려 보니 절반쯤 맞았다. 정확도를 올려야 했는데, 막상 손을 대려니 “무엇과 비교해서 정확한가”부터 정해야 했다.
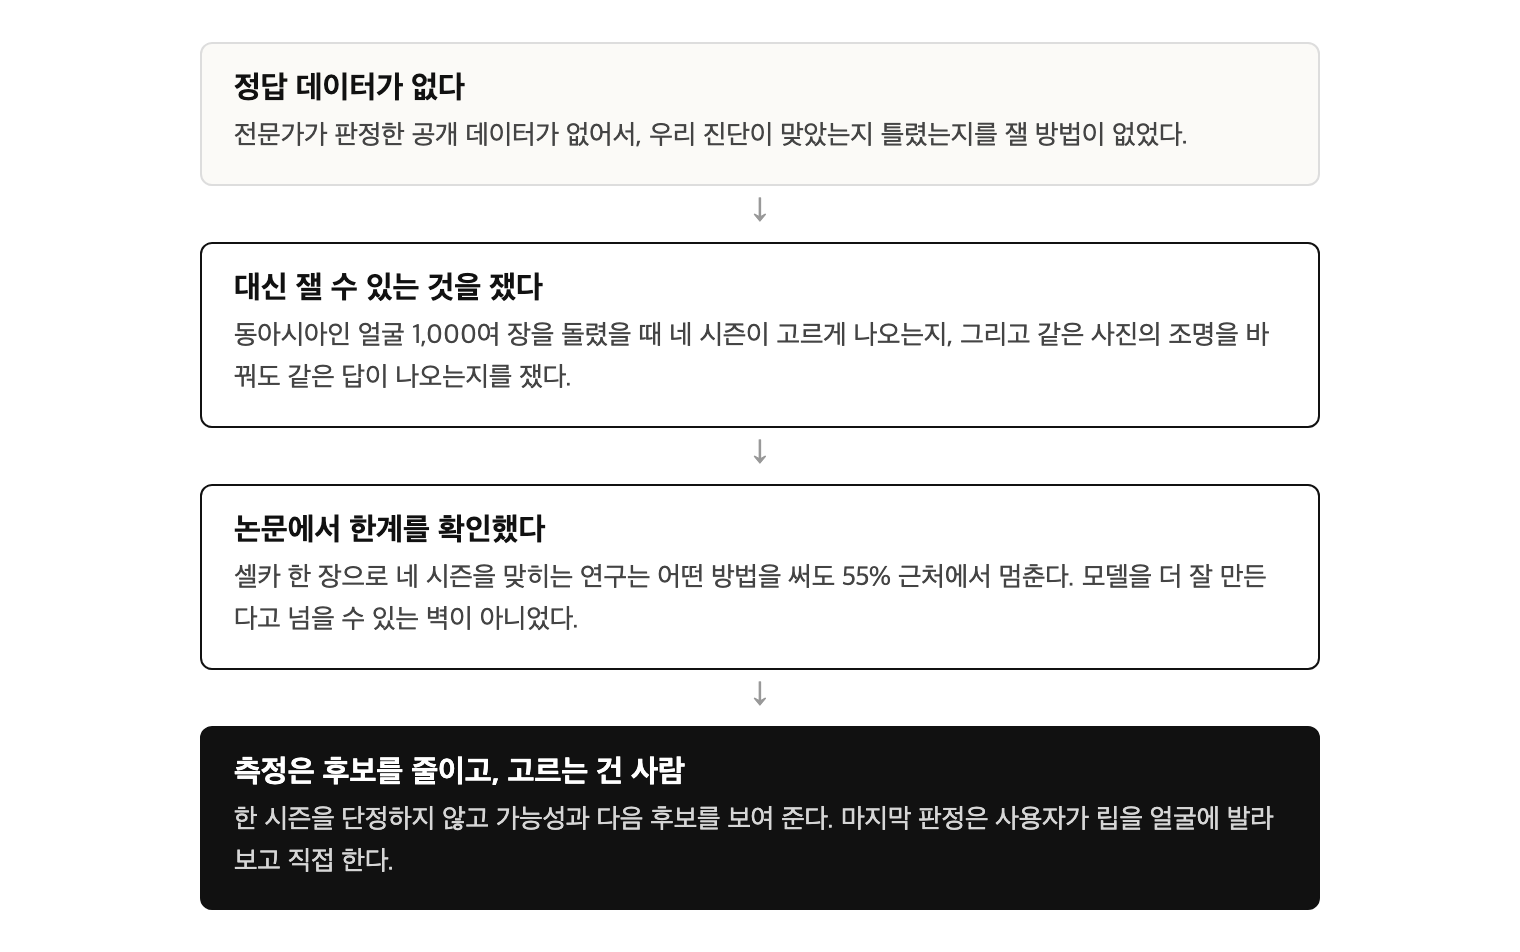
잴 수 있는 두 가지를 쟀더니 둘 다 안 좋았다. 네 시즌 중 겨울이 38%로 쏠려 있었고, 조명을 바꾸면 답이 자주 바뀌었다. 쏠림은 기준값을 다시 잡아서 네 시즌이 22~28%로 고르게 나오게 했다. 조명은 보정 방법 자체를 바꿨다. 전에는 사진 전체의 평균색으로 조명을 추정했는데, 그러면 벽이나 옷 색까지 조명으로 착각한다. 지금은 얼굴 안에 있는 흰 것, 즉 치아와 눈 흰자를 기준으로 조명을 되돌린다.
| 전 | 후 | |
|---|---|---|
| 조명을 바꿔도 같은 시즌이 나오는 비율 | 84% | 87% |
| 같은 비율, 12타입 기준 | 64% | 75% |
그러고 나서 논문을 찾아봤다. 셀카 한 장으로 네 시즌을 맞히는 연구는 방법이 달라도 전부 55% 근처에서 멈춘다. 모델을 더 잘 만든다고 넘을 수 있는 벽이 아니었다. 그래서 한 시즌을 단정하지 않고 확률과 다음 후보를 같이 보여 주기로 했다. 마지막 판정은 사용자 눈에 맡긴다. 두 색을 번갈아 발라 보고 고르는 “셀프 비교”가 여기서 나왔다.
판단 기준: 측정은 후보를 줄이는 역할이고, 고르는 건 사람이다.
이 뒤의 결정은 전부 이 기준에서 나왔다.
4. 어울린다는 립이 하나도 안 어울렸다
서비스 중심을 “내 립 찾기”로 옮기고, 올리브영 베스트셀러 립 90색에 어울림 점수를 매겼다. 그런데 내 얼굴로 돌려 보니 1등이라는 립이 하나도 안 어울렸다. 점수를 세 번 다시 만들었다.
| 방식 | 문제 | |
|---|---|---|
| 첫 번째 | 립은 피부보다 어둡게, 색은 피부에서 너무 멀지 않게, 채도는 비슷하게. 연구 규칙을 그대로 옮김 | 조건을 어느 정도 만족하면 전부 100점 |
| 두 번째 | 가장 알맞은 지점에서 멀어질수록 깎이게 | 100점은 사라졌지만 여전히 안 어울림 |
| 세 번째 | 가장 알맞은 지점을 사람마다 다르게 | 피부색이 다른 얼굴 넷의 1등이 전부 달라짐 |
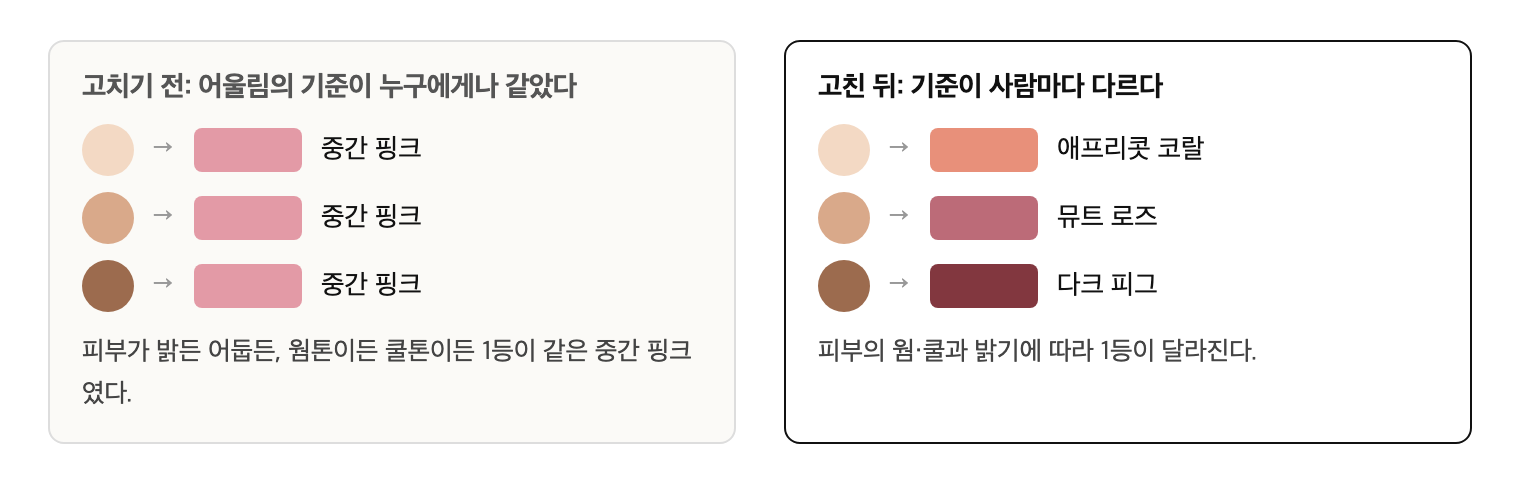
두 번째까지 안 어울렸던 이유는 “가장 알맞은 지점”이 모든 사람에게 같았기 때문이다. 세 번째 점수는 그 지점을 사람마다 다르게 잡는다. 쿨톤이면 핑크 쪽 색이, 웜톤이면 코랄 쪽 색이 기준점이 된다. 피부가 밝은 라이트 타입이면 연한 립이, 어두운 딥 타입이면 진한 립이 기준점이 된다. 비교할 때는 제품 색 그대로가 아니라 “이 사람 입술에 발랐을 때 보일 색”을 쓴다.
점수를 매기는 기준은 아홉 가지다.
| 기준 | 무엇을 보나 |
|---|---|
| 진하기 | 립이 피부보다 알맞게 진한가 |
| 웜·쿨 방향 | 내 톤 방향(코랄 쪽 또는 핑크 쪽)의 색인가 |
| 혈색 | 발랐을 때 혈색이 살아 보이는가 |
| 선명함 | 피부에 비해 너무 선명하거나 흐리지 않은가 |
| 피부와의 조화 | 피부색과 립 색이 어우러지는가 |
| 내 톤 팔레트 | 내 시즌 팔레트의 색에 가까운가 |
| 유행 | 요즘 많이 찾는 색인가 (올리브영 월간 베스트 순위) |
| 원하는 느낌 | 내가 답한 느낌(자연스러운, 화사한, 또렷한)에 맞는가 |
| 질감 | 내가 좋아한다고 답한 질감인가 |
바꾼 뒤 피부색이 다른 얼굴 넷으로 전체 제품의 점수를 뽑아 봤다. 1등이 체리 레드, 뮤트 로즈, 브릭 레드, 다크 피그로 전부 달랐고, 1등은 80점대, 중간은 60~70점대다. 100점은 없다. 이 결과는 자동 테스트로 적어 두어서, 나중에 점수를 고쳤다가 웜과 쿨의 1등이 다시 같아지면 테스트가 실패한다.
제품 색은 직접 뽑았다
한국 브랜드 립 색을 무료로 주는 데이터는 없었다. 쇼핑몰을 크롤링하면 약관 문제도 있고 색의 출처를 설명할 수 없다. 대신 브랜드 공식 사이트의 색상 칩과 발색 사진에서 색을 직접 뽑았다. 196색 중 173색이 이렇게 잰 값이고, 색마다 출처를 적어 뒀다.
발색이 스티커 같았다
립을 얹는 렌더링도 두 번 갈아엎었다. 처음에는 제품 색을 반투명하게 덮었는데 밝은 제품이 형광처럼 떴다. 색을 덜 올리니 이번엔 묽어지고, 입술의 반짝이는 부분까지 색이 덮여서 스티커 같았다. 지금은 밝기, 반짝임, 명암을 따로 다룬다. 밝기는 일부만 옮기고, 원래 반짝이던 자리에는 색을 덜 묻히고, 밝게 띄울수록 명암 폭을 같이 키운다.
5. 측정 뒤 화면을 다섯 단계로
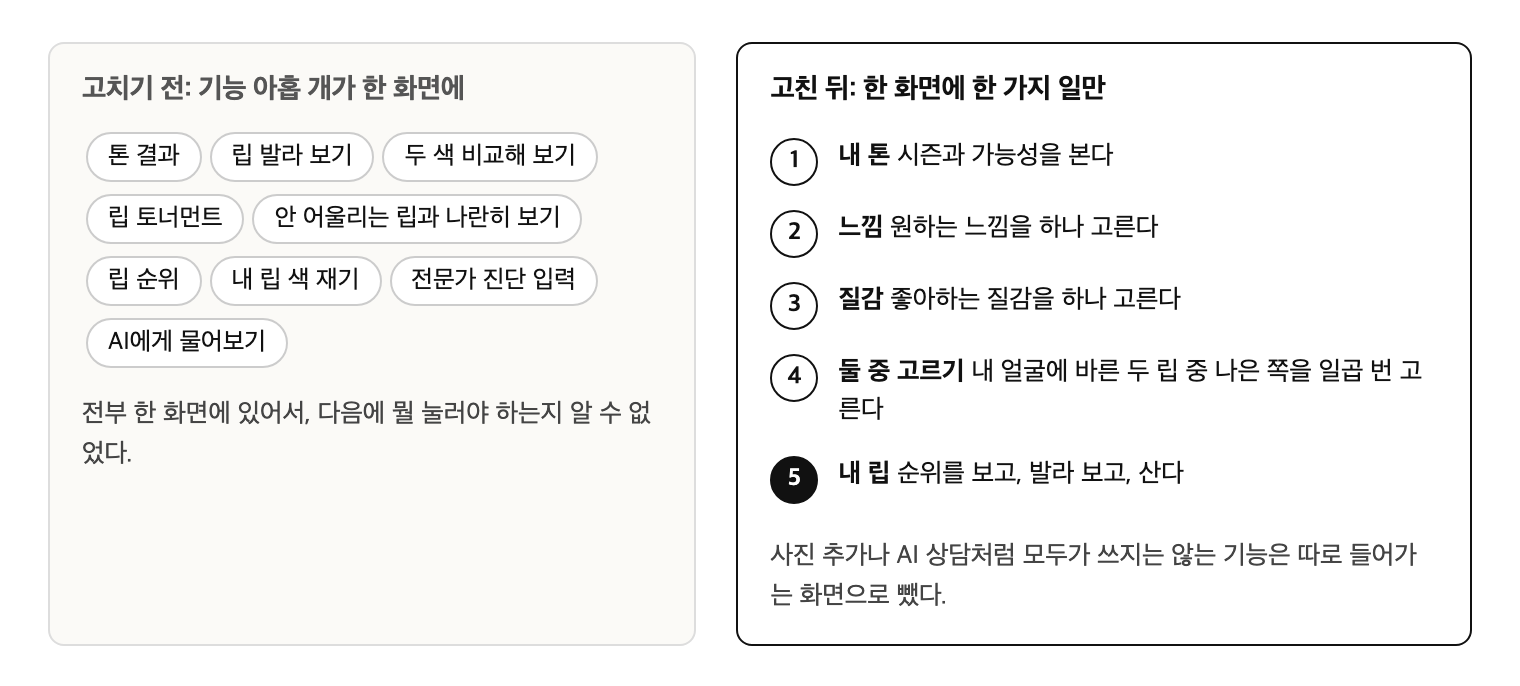
기능이 늘어나는 동안 측정 뒤 화면은 쌓이기만 했다. 만든 나도 다음에 뭘 눌러야 하는지 몰랐다. 한 화면에 한 가지 일만 두기로 하고 다섯 단계로 나눴다. 모두가 쓰지 않는 기능은 곁가지로 뺐다.
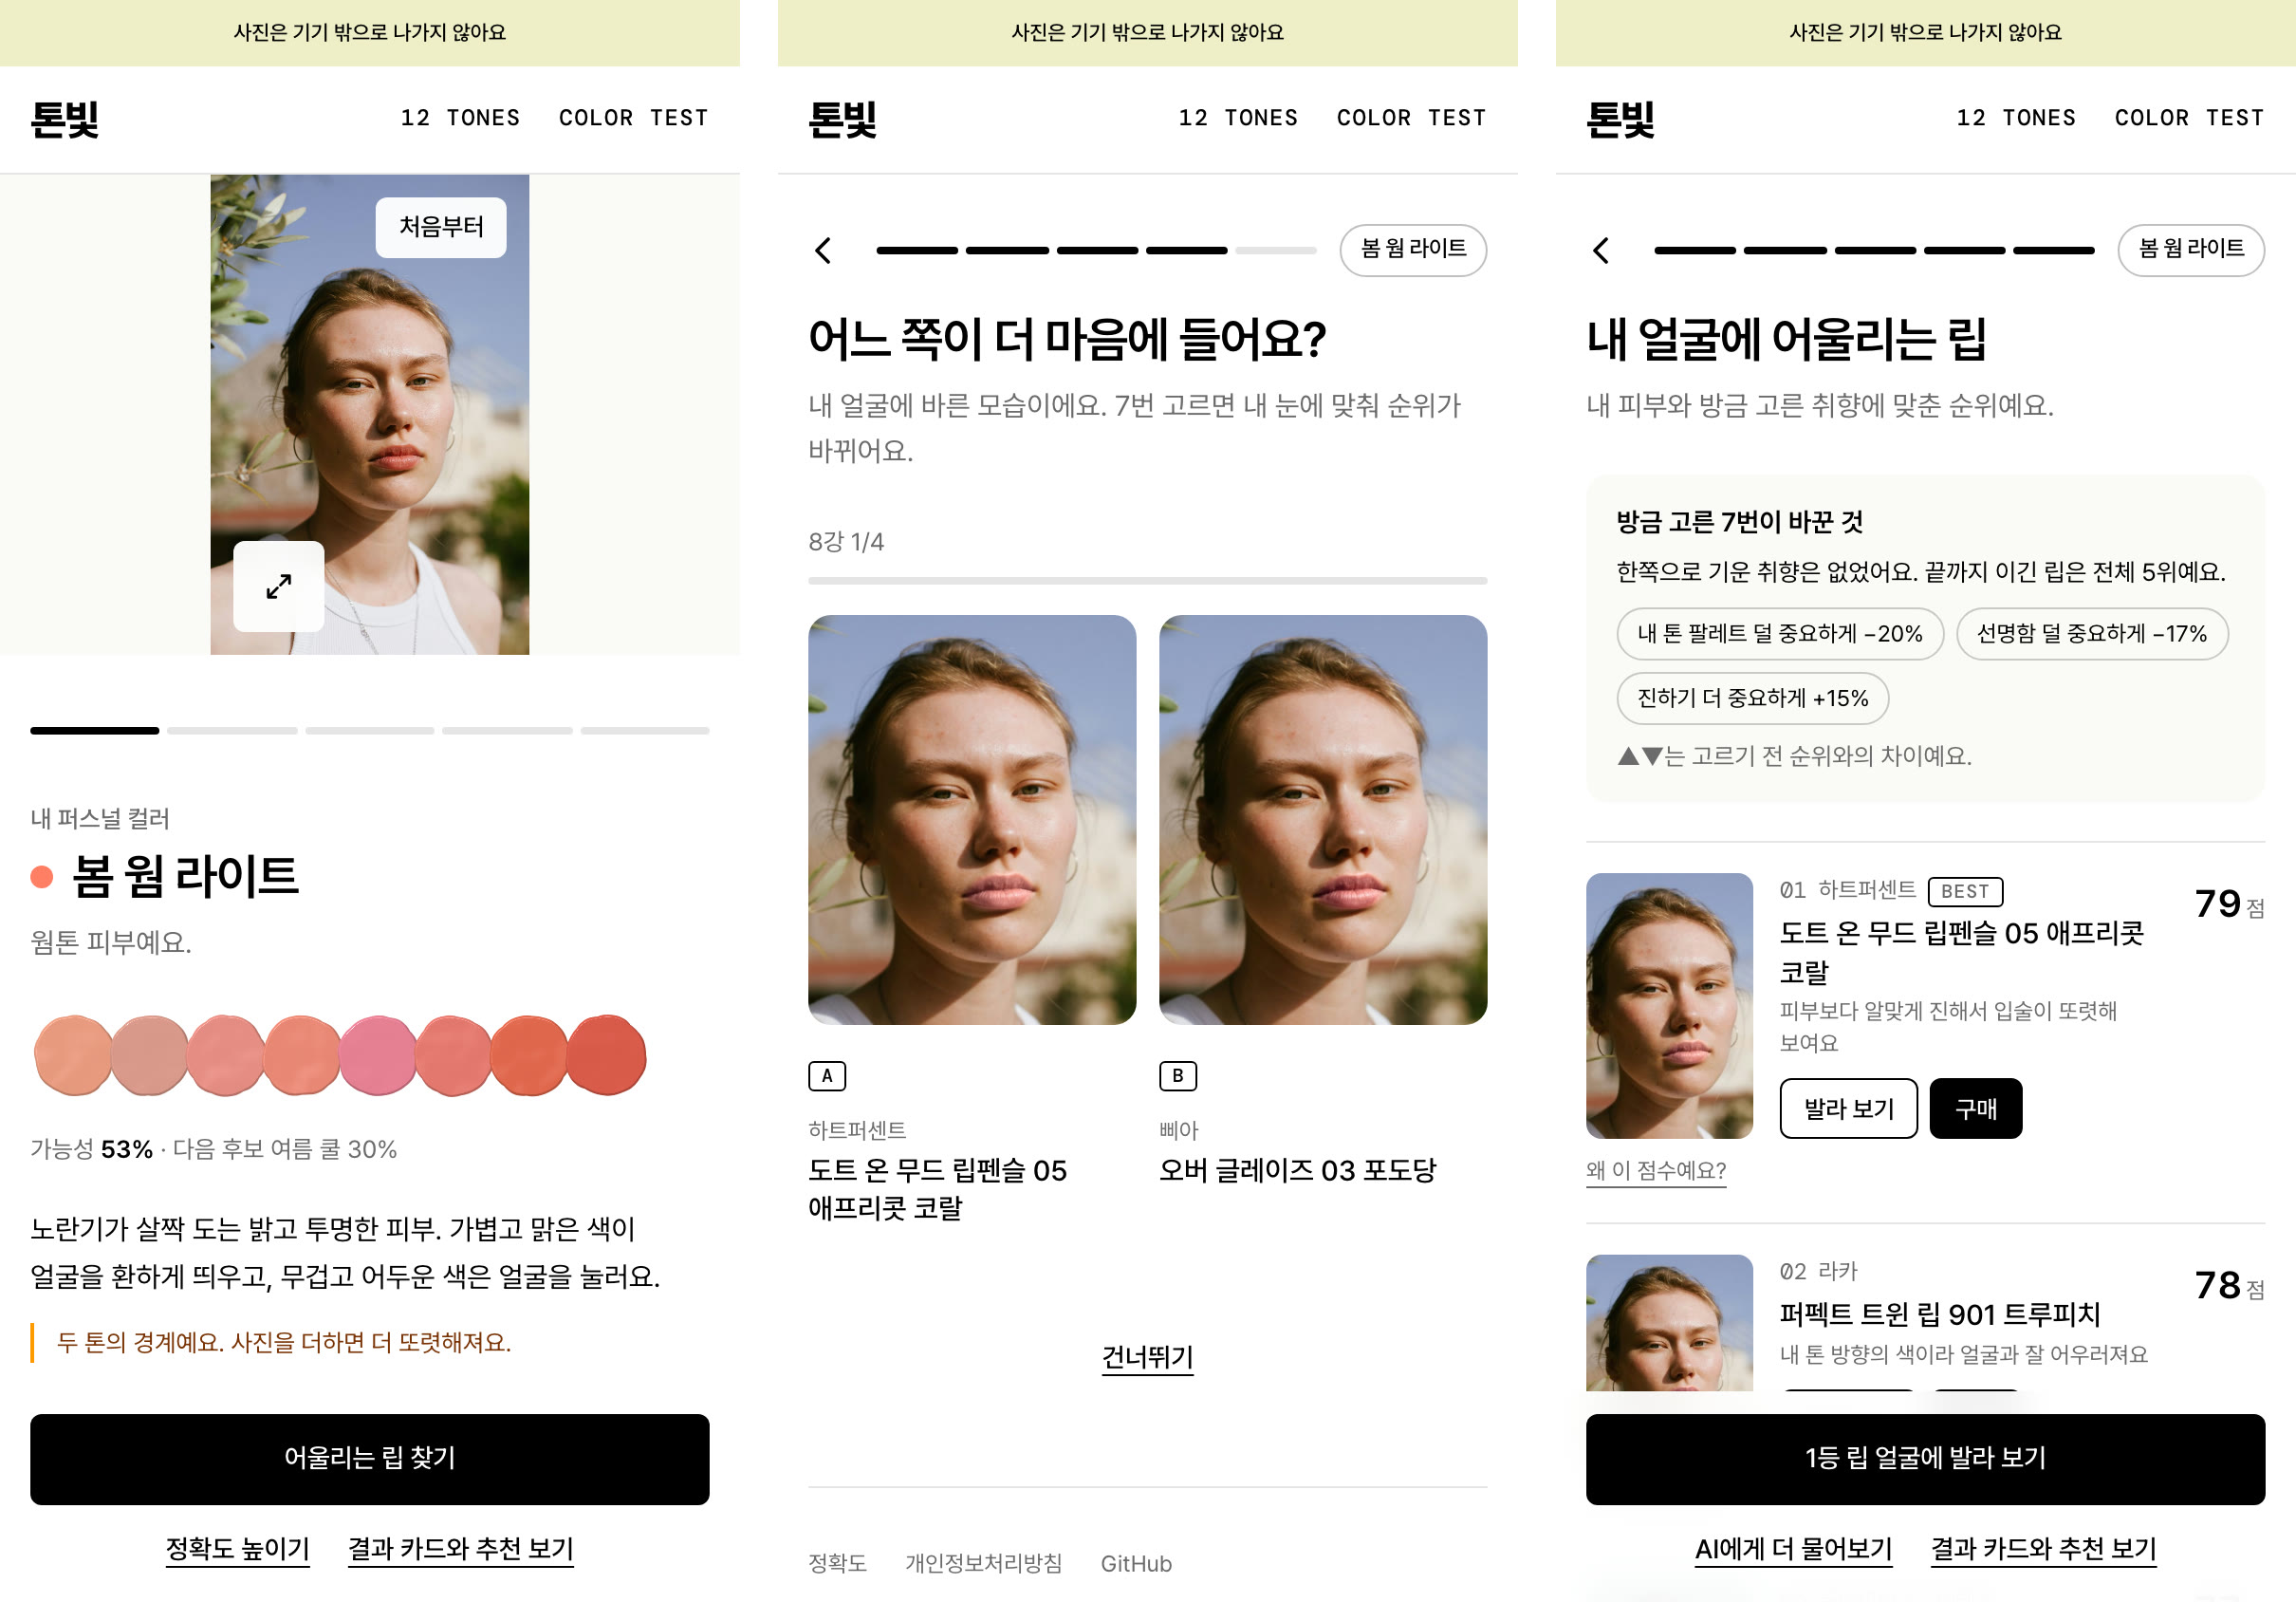
폰에서 쓰는 걸 기본으로 놓았다. 뒤로 가기는 브라우저 뒤로 가기와 같아서, 뒤로 스와이프하면 이전 단계로 돌아간다. 사진은 질문 화면에서 숨기고, 내 톤 화면에서는 작게, 발라 보기에서만 위에 고정했다. 진행 막대와 다음 버튼은 화면 아래에 붙여 엄지로 바로 닿는다.
둘 중 고르기: 내 눈으로 고른 결과가 순위에 들어간다
“측정은 후보를 줄이고 고르는 건 사람”이라는 기준을 제품에도 적용한 게 둘 중 고르기다. 점수 상위에서 서로 다른 8색을 뽑아 내 얼굴에 바른 사진을 두 장씩 보여 주고, 더 나은 쪽을 고른다. 일곱 번 고르면 끝까지 이긴 립에 “내 1등”이 붙는다. 고른 결과는 점수에도 들어간다. 내가 고른 쪽이 더 높은 점수를 받도록 아홉 기준의 비중을 조금씩 옮기는 식이다.
처음엔 기준을 전부 움직이게 했더니 일곱 번 고른 걸로 작은 항목 하나가 −70%까지 튀었다. 일곱 번은 아홉 개를 정하기엔 너무 적어서 우연에 맞춰진 것이었다. 지금은 진하기, 웜·쿨 방향, 혈색, 선명함, 시즌 팔레트 다섯 가지만 움직인다.
직접 써 보고 고친 것
여기까지 만들고 처음부터 끝까지 직접 써 봤다. 기능은 다 있는데 “이게 뭐지?” 싶은 데가 세 군데 나왔다.
| 써 보니 걸린 것 | 바꾼 것 |
|---|---|
| 진단이 끝났는데 내 퍼스널 컬러가 뭔지 한눈에 안 들어왔다. 사진이 화면을 거의 다 차지하고, 시즌 이름은 그 밑에 작게 있었다. | 폰에서는 사진을 줄이고, 그 자리에 “내 퍼스널 컬러”라는 제목과 시즌 색 점, 웜톤인지 쿨톤인지 한 문장을 올렸다. 다음 화면부터는 오른쪽 위에 “봄 웜 라이트” 같은 표시가 계속 따라다닌다. |
| 둘 중 고르기를 일곱 번 하고 나서도 그게 결과에 뭘 바꿨는지 알 수 없었다. 그냥 순위가 나올 뿐이었다. | 순위 맨 위에 “방금 고른 7번이 바꾼 것”이라는 상자를 뒀다. 내가 고른 경향을 “더 진한 색을 골랐어요”처럼 한 줄로 말해 주고, 비중이 어떻게 바뀌었는지를 “진하기 더 중요하게 +16%”처럼 보여 주고, 각 순위 옆에 고르기 전보다 몇 계단 오르내렸는지 ▲▼로 붙였다. |
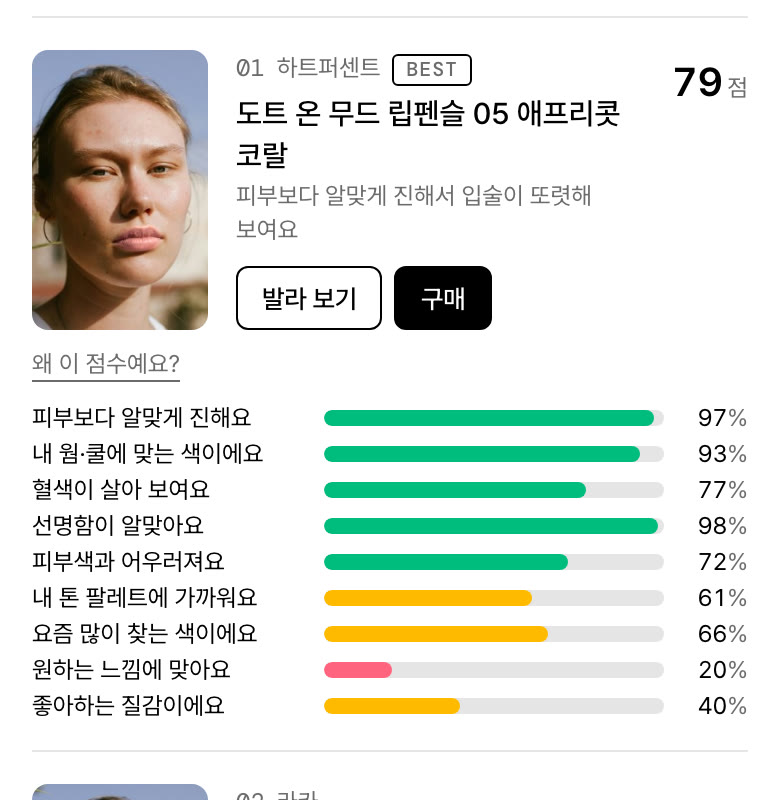
| 항목별 점수가 안 읽혔다. 막대가 작고 전부 검은색이었고, 항목 이름이 “치아”, “인상”처럼 무슨 뜻인지 알 수 없는 말이었다. | 항목 이름을 버리고 “피부보다 알맞게 진해요” 같은 문장으로 바꿨다. 막대는 키우고, 점수에 따라 초록·노랑·분홍으로 칠하고, 퍼센트를 붙였다. “치아” 항목은 누구에게나 차가운 색을 조금씩 밀어 주는 항목이라 아예 뺐다. |
| 화면마다 글이 너무 많았다. 모든 화면 아래에 같은 안내문과 측정 숫자가 반복됐고, “확신도”, “보정 기준” 같은 말이 그대로 노출됐다. | 반복되는 안내는 내 톤 화면과 정확도 높이기 화면에만 남기고, 용어와 같은 말의 두 번째 문장을 뺐다. 글자 크기는 그대로 두고, 한 화면에 꼭 필요한 문장만 남겼다. |
6. 결과
| 첫 버전 (10월 13일) | 지금 | |
|---|---|---|
| 진단 | 한 시즌을 단정 | 확률과 다음 후보, 근거 문장. 최종 판정은 사용자의 눈 |
| 립 | 시즌 팔레트를 발라 보는 것까지 | 196색 순위, 그 립을 바른 내 얼굴, 구매 링크 |
| 점수 | 없음 | 아홉 가지 기준, 사람마다 다른 기준점, 내 선택으로 비중 조정 |
| 제품 색 | 눈대중 | 173색을 브랜드 공식 칩·발색에서 실측 |
| 화면 | 탭 하나에 전부 | 다섯 단계, 곁가지 둘 |
마치며
처음 목표는 진단에서 구매까지 한 줄로 이어지는 서비스였지, 진단을 잘하는 것 자체는 아니었다. 정확도 55%라는 벽은 넘지 못했지만, 그 벽 덕분에 “측정은 후보를 줄이고 고르는 건 사람”이라는 흐름이 생겼다. 돌아보면 그게 처음 의도에 더 가까웠다. 진단 결과를 통보받는 것보다, 내 얼굴에 발라 본 두 립 중 하나를 고르는 쪽이 구매까지 훨씬 자연스럽게 이어진다.
개인적으로 가장 잘한 결정은 점수를 두 번째로 고쳤을 때 분포가 예뻐졌는데도 “그래도 안 어울린다”를 그냥 넘기지 않은 것이다. 숫자가 괜찮아 보여도 내 얼굴로 써 보면 바로 티가 났다. 그 느낌을 “피부색이 다른 얼굴 셋에서 1등이 같으면 안 된다”는 기준으로 바꾸고 나서야 고칠 수 있었다.
다음은 이 흐름이 정말 구매로 이어지는지 숫자로 보는 일이다. 측정을 마쳤는지, 둘 중 고르기를 끝냈는지, 어느 화면에서 몇 위 제품의 구매 링크를 눌렀는지를 남기고 있으니, 쌓이면 어디서 끊기는지부터 볼 생각이다.
참고
- Kärkkäinen, K., & Joo, J. (2021). FairFace. WACV.
- Choi, K., Choi, J., & Suk, H.-J. (2017). The human sclera and pupil as the calibration targets. IS&T Electronic Imaging.
- Hirayama, H. 외 (1998). 립 컬러와 피부색의 조화에 관한 연구. 粧技誌 32(2).
- Ou, L.-C., & Luo, M. R. (2006). A colour harmony model for two-colour combinations. Color Research & Application 31(3).
- 코드와 수치 전체: github.com/OHaEuN/tonebit의
docs/color-analysis.md,docs/lip.md.