<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" xml:lang="ko_KR"><generator uri="https://jekyllrb.com/" version="4.4.1">Jekyll</generator><link href="https://ohaeun.github.io/OHaEuN/rss.xml" rel="self" type="application/atom+xml" /><link href="https://ohaeun.github.io/OHaEuN/" rel="alternate" type="text/html" hreflang="ko_KR" /><updated>2026-11-11T14:26:05+09:00</updated><id>https://ohaeun.github.io/OHaEuN/rss.xml</id><title type="html">haeun.log</title><subtitle>haeun.log — 프론트엔드 기술 블로그</subtitle><author><name>OHaEuN</name></author><entry><title type="html">만들고 난 뒤에 톤빛 기획 문서를 쓰면서 고친 것들</title><link href="https://ohaeun.github.io/OHaEuN/33" rel="alternate" type="text/html" title="만들고 난 뒤에 톤빛 기획 문서를 쓰면서 고친 것들" /><published>2026-11-11T13:00:00+09:00</published><updated>2026-11-11T13:00:00+09:00</updated><id>https://ohaeun.github.io/OHaEuN/33</id><content type="html" xml:base="https://ohaeun.github.io/OHaEuN/33"><![CDATA[<p><a href="/OHaEuN/31">지난 글</a>에서 톤빛을 하루 만에 만들고 3주 동안 어떻게 바꿔 왔는지 적었다. 그 글을 포트폴리오에 붙이려고 다시 읽어 보니 코드와 회고는 있는데, 정작 “왜 이렇게 정했는지”를 적어 둔 문서가 없었다. 팀에서 일할 때는 기획자가 시장조사부터 화면설계서까지 먼저 써 두고 그 위에서 개발이 돌아가는데, 혼자 만들다 보니 그 단계를 통째로 건너뛴 것이다.</p>

<p>그래서 이번에는 반대로 해 봤다. 이미 돌아가고 있는 서비스를 보면서, 기획자였다면 썼을 문서를 하나씩 채웠다. 사후에 쓴 문서라는 건 문서 첫 줄에 적어 두었다. 쓰는 데 하루가 걸렸고, 그 하루 동안 서비스에 빠져 있던 것 아홉 가지가 나왔다.</p>

<blockquote>
  <p><strong>결과:</strong> 기획 문서 여덟 편(시장조사, 서비스 기획서, 요구사항 정의서, 정책서, 정보구조와 흐름, 화면설계서, 지표와 이벤트 설계, 출시·운영 계획)을 썼다. 쓰면서 빠진 것 아홉 가지를 찾았고 그중 다섯 가지는 그날 고쳐서 배포했다. 서비스를 실제로 바꾼 문서는 정책서와 지표 설계 두 편이었다.</p>
</blockquote>

<p>문서는 저장소의 <a href="https://github.com/OHaEuN/tonebit/tree/master/docs/planning">docs/planning</a>에 올려 두었다.</p>

<hr />

<h2 id="1-무엇을-썼나">1. 무엇을 썼나</h2>

<table data-ke-align="alignLeft">
  <thead>
    <tr>
      <th>문서</th>
      <th>어떤 질문에 답하나</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>사전 시장조사</td>
      <td>이 시장에 들어갈 이유가 있나, 누가 이미 하고 있나</td>
    </tr>
    <tr>
      <td>서비스 기획서</td>
      <td>누구의 어떤 문제를 어떻게 풀고, 성공은 무엇으로 재나</td>
    </tr>
    <tr>
      <td>요구사항 정의서</td>
      <td>무엇을 꼭 만들고 무엇은 안 만드나</td>
    </tr>
    <tr>
      <td>서비스 정책서</td>
      <td>애매한 상황에서 서비스가 어떻게 판단하나</td>
    </tr>
    <tr>
      <td>정보구조와 사용자 흐름</td>
      <td>화면이 어떻게 이어지고 어디서 갈라지나</td>
    </tr>
    <tr>
      <td>화면설계서</td>
      <td>각 화면에 무엇이 있고 눌렀을 때 무슨 일이 나나</td>
    </tr>
    <tr>
      <td>지표와 이벤트 설계</td>
      <td>잘 되고 있는지 무엇으로 알고 어떻게 남기나</td>
    </tr>
    <tr>
      <td>출시·운영 계획</td>
      <td>언제 무엇을 확인하고 내보내며, 무엇이 위험한가</td>
    </tr>
  </tbody>
</table>

<p>시장조사의 숫자는 출처 페이지를 직접 열어 확인한 것만 적었다. 오프라인 진단이 4만 원대에서 시작해 평균 6만 원대라는 것, 한 예약 플랫폼에서는 외국인 손님의 뷰티숍 결제 가운데 80%가 퍼스널 컬러 진단이었다는 것, 올리브영이 올해 안에 피부 진단 앱에 퍼스널 컬러를 넣는다는 것. 이 셋을 놓고 보면 업계가 진단에서 구매로 이어지는 쪽으로 가고 있고, 집에서 무료로 그 흐름을 끝까지 해 주는 서비스는 아직 없다. 톤빛은 그 자리를 보고 만든 셈이라, 시장조사는 쓰면서 방향을 다시 확인하는 정도였다.</p>

<p>나머지 일곱 편은 이미 있는 서비스를 문서로 옮겨 적는 일에 가까웠다. 그런데 옮겨 적다 보니 문서에는 써 놓고 서비스에는 없는 것이 자꾸 나왔다.</p>

<hr />

<h2 id="2-쓰면서-걸린-것">2. 쓰면서 걸린 것</h2>

<table data-ke-align="alignLeft">
  <thead>
    <tr>
      <th>어느 문서에서</th>
      <th>무엇이 걸렸나</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>지표 설계</td>
      <td>퍼널을 여섯 단계로 적어 놓고 실제 이벤트는 측정 완료와 구매 클릭뿐이었다. 그 사이 네 단계에서 어디서 빠져나가는지 볼 방법이 없었다</td>
    </tr>
    <tr>
      <td>정책서</td>
      <td>“구매 링크가 있는 화면에는 모두 파트너스 고지를 둔다”고 쓰고 화면을 열어 보니, 발라 보기 화면에는 고지가 없었다</td>
    </tr>
    <tr>
      <td>정책서</td>
      <td>“인기 순위는 분기마다 갱신한다”고 썼는데, 보는 사람은 그 순위가 언제 것인지 알 길이 없었다</td>
    </tr>
    <tr>
      <td>기획서</td>
      <td>목표 “결과를 믿을 수 있다”를 재는 지표가 체감 일치율인데, 그걸 묻는 카드가 정확도 높이기 화면에만 있었다. 거기까지 들어온 사람의 답만 모인다</td>
    </tr>
    <tr>
      <td>출시 계획</td>
      <td>아이폰 사진 회전은 실기기로 한 번 눌러 본 게 확인의 전부였다</td>
    </tr>
    <tr>
      <td>화면설계서</td>
      <td>공유되는 결과 카드가 톤별 공용이라 내 1등 립이 들어가지 않는다</td>
    </tr>
    <tr>
      <td>시장조사</td>
      <td>수요가 가장 큰 쪽이 외국인인데 서비스는 한국어뿐이다</td>
    </tr>
    <tr>
      <td>지표 설계</td>
      <td>목표로 적은 숫자가 전부 가설이다</td>
    </tr>
    <tr>
      <td>요구사항</td>
      <td>접근성을 “완료”라고 써 놓고 검사 도구를 돌린 적이 없다</td>
    </tr>
  </tbody>
</table>

<p>앞의 다섯 가지는 하나씩 한두 시간이면 되는 일인데 3주 동안 한 번도 안 했다. 기능을 만들 때는 그 기능만 보게 되고, 고지가 빠졌는지나 순위가 언제 것인지 같은 건 누가 물어보기 전에는 생각이 나지 않았기 때문이다. 문서를 쓰는 일이 그 질문을 대신 해 준 셈이다.</p>

<hr />

<h2 id="3-그날-고친-것">3. 그날 고친 것</h2>

<h3 id="화면이-바뀔-때마다-이벤트를-보낸다">화면이 바뀔 때마다 이벤트를 보낸다</h3>

<p>측정이 끝난 뒤 화면이 바뀔 때마다 어느 화면인지 보내는 이벤트를 넣었다. 내 톤, 느낌, 질감, 둘 중 고르기, 순위, 발라 보기, 정확도 높이기, AI 상담까지 전부 남는다. 측정 완료 이벤트에는 사진 몇 장을 합쳤는지도 같이 보내게 했다. 사진 장수와 확신도가 어떤 관계인지는 4주쯤 쌓이면 볼 수 있을 것 같다.</p>

<h3 id="발라-보기-화면에도-파트너스-고지">발라 보기 화면에도 파트너스 고지</h3>

<p>정책서에 고지 규칙을 쓰고 나서 화면을 하나씩 열어 보니 순위 화면에는 있고 발라 보기 화면에는 없었다. 고지 문단을 컴포넌트 하나로 빼서 두 화면이 같은 걸 쓰게 했다. 앞으로 구매 링크가 있는 화면이 늘어도 이 컴포넌트만 넣으면 된다.</p>

<h3 id="순위에-기준-시점을-적는다">순위에 기준 시점을 적는다</h3>

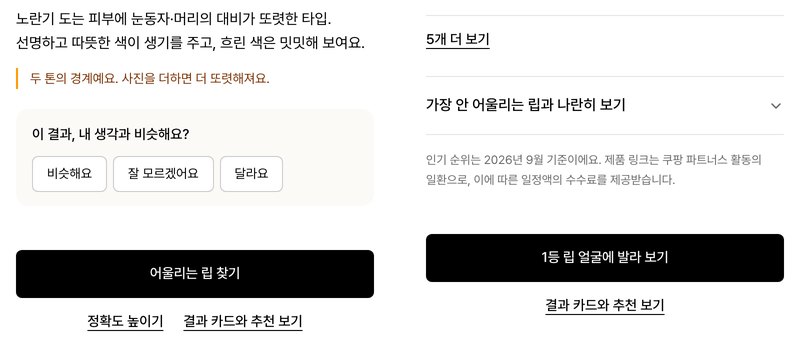
<p>순위 데이터는 분기마다 손으로 갱신하는데 화면에는 그게 언제 것인지 적혀 있지 않았다. 적지 않으면 보는 사람은 지금 순위로 읽는다. 순위 화면 아래에 “인기 순위는 2026년 9월 기준이에요” 한 줄을 넣고, 날짜는 상수로 두어 데이터를 갱신할 때 같이 바꾸도록 했다.</p>

<h3 id="반응-카드를-내-톤-화면으로-옮겼다">반응 카드를 내 톤 화면으로 옮겼다</h3>

<p>“이 결과, 내 생각과 비슷해요?”라고 묻는 카드가 정확도 높이기 화면에만 있었다. 거기까지 들어오는 사람은 결과가 미심쩍어서 온 경우가 많을 테니, 그 답만 모으면 정확도가 실제보다 낮게 잡힌다. 측정을 끝낸 사람이 모두 보는 내 톤 화면으로 옮겼다. 지난 글에서 화면마다 글을 줄였던 걸 생각하면 주 화면에 질문을 하나 더하는 게 마음에 걸렸지만, 쓸 수 있는 숫자를 얻는 쪽이 낫다고 봤다. 전문가 진단 입력은 그대로 정확도 높이기에 두고, 달라요를 누르면 그리로 이어지게 했다.</p>

<figure class="imageblock alignCenter">
  <p><img src="/OHaEuN/assets/posts/33/review.jpg" alt="왼쪽: 내 톤 화면 아래로 옮긴 반응 카드. 오른쪽: 순위 화면 아래 기준 시점과 파트너스 고지" /></p>
</figure>

<h3 id="눕혀-저장된-사진을-테스트에-넣었다">눕혀 저장된 사진을 테스트에 넣었다</h3>

<p>폰으로 찍은 사진은 픽셀은 눕혀 저장하고 EXIF에 회전 정보만 적는 경우가 많다. 지금까지는 아이폰 실기기로 한 번 확인하고 넘어갔는데, 그런 사진을 픽스처로 만들어 올리면 세로로 세워서 측정하는지 E2E 테스트에 넣었다. 브라우저의 기본 회전 처리에 맡기는 설계라 코드는 바뀐 게 없고 테스트만 늘었다.</p>

<hr />

<h2 id="4-미룬-것">4. 미룬 것</h2>

<table data-ke-align="alignLeft">
  <thead>
    <tr>
      <th>항목</th>
      <th>왜 미뤘나</th>
      <th>언제 하나</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>결과 카드에 내 1등 립 넣기</td>
      <td>서버에서 그리는 카드가 톤별 공용이라 구조를 바꿔야 한다</td>
      <td>공유율이 3%를 넘으면</td>
    </tr>
    <tr>
      <td>영어</td>
      <td>수요는 외국인이 가장 크지만 지금 유입이 없다</td>
      <td>해외 유입이 잡히면</td>
    </tr>
    <tr>
      <td>지표 목표 숫자</td>
      <td>측정 완료율 60%, 구매 클릭 5% 같은 숫자가 전부 가설이다</td>
      <td>4주 뒤 실제 값으로 바꾼다</td>
    </tr>
    <tr>
      <td>접근성 검사</td>
      <td>요구사항에 “완료”라고 써 놓고 검사 도구를 돌린 적이 없다</td>
      <td>상태를 “확인 필요”로 고쳤고, axe를 돌리는 게 다음 일이다</td>
    </tr>
  </tbody>
</table>

<hr />

<h2 id="5-어떤-문서가-쓸모-있었나">5. 어떤 문서가 쓸모 있었나</h2>

<p>빠진 걸 찾아낸 건 거의 정책서와 지표 설계였다. 기획서와 화면설계서는 있는 화면을 보고 옮겨 적으면 끝났다. 정책서는 “이 경우에는 이렇게 한다”를 한 줄씩 써야 해서 정해 두지 않은 게 바로 드러났고, 지표 설계는 “이 숫자는 어떤 이벤트로 재나”를 쓰다 보면 이벤트가 없는 게 보였다.</p>

<blockquote data-ke-style="style1">
  <p>판단 기준: <strong>쓰고 나서 서비스가 바뀐 게 없는 문서는 다음 프로젝트에서는 건너뛴다.</strong></p>
</blockquote>

<p>다음에 사이드 프로젝트를 또 한다면 여덟 편을 다 쓰지는 않을 것 같다. 정책서와 지표 설계 두 편은 만들기 전에 쓰고, 나머지는 만든 뒤에 필요하면 채우는 정도가 혼자 하는 프로젝트에는 맞는 것 같다. 처음부터 여덟 편을 썼다면 첫 버전이 하루 만에 나오지는 않았을 것이다.</p>

<h2 id="마치며">마치며</h2>

<p>문서 없이 3주를 고쳤는데, 문서 쓰는 데 하루를 쓰고 나니 다섯 가지가 더 고쳐졌다. 개인적으로는 반응 카드를 내 톤 화면으로 옮긴 게 가장 잘한 결정이라고 생각한다. 이게 있어야 정확도 이야기를 숫자로 할 수 있기 때문이다.</p>

<p>다음은 4주 뒤에 퍼널 숫자를 보는 일이다. 가설로 적어 둔 측정 완료율 60%, 구매 클릭 5%가 실제로 얼마였는지, 그래서 무엇을 바꿨는지를 다음 글에 적으려고 한다.</p>]]></content><author><name>OHaEuN</name></author><category term="Front-end" /><category term="톤빛" /><category term="사이드 프로젝트" /><category term="기획" /><category term="프로덕트" /><category term="지표" /><summary type="html"><![CDATA[이미 돌아가고 있는 톤빛을 보면서 기획자였다면 썼을 문서 여덟 편을 거꾸로 채웠다. 쓰는 동안 서비스에 빠져 있던 것 아홉 가지가 나왔고, 다섯 가지는 그날 고쳐서 배포했다. 어떤 문서가 실제로 서비스를 바꿨는지 정리했다.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://ohaeun.github.io/OHaEuN/assets/posts/33/thumbnail.jpg" /><media:content medium="image" url="https://ohaeun.github.io/OHaEuN/assets/posts/33/thumbnail.jpg" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">[백엔드 입문 #9] 레거시 MyBatis 코드로 본 SQL 매핑과 SQL 인젝션</title><link href="https://ohaeun.github.io/OHaEuN/32" rel="alternate" type="text/html" title="[백엔드 입문 #9] 레거시 MyBatis 코드로 본 SQL 매핑과 SQL 인젝션" /><published>2026-11-09T11:50:00+09:00</published><updated>2026-11-09T11:50:00+09:00</updated><id>https://ohaeun.github.io/OHaEuN/32</id><content type="html" xml:base="https://ohaeun.github.io/OHaEuN/32"><![CDATA[<p><a href="/OHaEuN/30">지난 글</a>까지는 신규 코드만 봤다. JPA에서는 <code>repository.findById(1L)</code>만 부르면 SQL이 알아서 만들어졌다. 그런데 오래된 레거시 코드를 열어 보니 XML 파일에 SQL이 그대로 적혀 있었다. 이번 글은 그 방식인 <strong>MyBatis</strong> 이야기다.</p>

<p>MyBatis는 문법이 많아서, 꼭 기억할 세 가지를 먼저 정리해 두고 시작한다.</p>

<blockquote>
  <ol>
    <li>MyBatis는 <strong>SQL을 사람이 직접 쓰고</strong>, 결과만 객체에 담아 준다.</li>
    <li>값은 반드시 <strong><code>#{}</code></strong> 로 넣는다. <code>${}</code>는 SQL 인젝션이 된다.</li>
    <li>쿼리 두 개가 <strong>같은 DB 연결</strong>을 써야 할 때가 있고, 그걸 보장하는 게 트랜잭션이다.</li>
  </ol>
</blockquote>

<blockquote>
  <p>글에 나오는 코드는 이해를 돕기 위해 일부 단순화했다.</p>
</blockquote>

<hr />

<h2 id="-jpa와-무엇이-다른가">① JPA와 무엇이 다른가</h2>

<table>
  <thead>
    <tr>
      <th> </th>
      <th>JPA</th>
      <th>MyBatis</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>SQL은 누가 쓰나</td>
      <td>JPA가 만들어 준다</td>
      <td>사람이 XML에 직접 쓴다</td>
    </tr>
    <tr>
      <td>결과물</td>
      <td>Entity (규칙을 가진 객체)</td>
      <td>DTO (데이터만 담는 그릇)</td>
    </tr>
    <tr>
      <td>값을 바꾸면</td>
      <td>변경 감지로 UPDATE가 자동으로 나간다</td>
      <td>UPDATE문을 직접 호출해야 한다</td>
    </tr>
    <tr>
      <td>프론트 비유</td>
      <td>Prisma 같은 ORM</td>
      <td>쿼리 문자열을 직접 짜서 보내기</td>
    </tr>
  </tbody>
</table>

<p>어느 쪽이 더 나은 건 아니다. 테이블 7개를 조인하는 복잡한 조회 화면은 SQL을 직접 쓰는 게 훨씬 편하다. 대신 규칙이 SQL 곳곳에 흩어지기 쉽다는 단점이 있다. 이 이야기는 ⑤에서 다시 한다.</p>

<hr />

<h2 id="-구조-인터페이스-하나-xml-하나">② 구조: 인터페이스 하나, XML 하나</h2>

<p>카트 목록 조회를 예로 따라가 봤다. Java 쪽에는 <strong>인터페이스만 있고 구현이 없다.</strong></p>

<pre><code class="language-java">@Mapper
public interface CartMapper {
    List&lt;CartSearchOutDTO&gt; selectCartList(CartSearchReqDTO reqDTO);
}
</code></pre>

<p>SQL은 XML에 있다.</p>

<pre><code class="language-xml">&lt;mapper namespace="com.example.wms.cart.mapper.CartMapper"&gt;        &lt;!-- 어느 인터페이스? --&gt;

    &lt;select id="selectCartList" resultType="CartSearchOutDTO"&gt;     &lt;!-- 어느 메서드? 결과는 어디에 담나? --&gt;
        SELECT cm.cart_id
              ,cm.cart_type_cd
              ,cm.cart_barcode_no
          FROM cart_mst cm
         WHERE cm.delete_yn = 'N'
           AND cm.sub_account_id = #{subAccountId}
          &lt;if test="cartTypeCd != null"&gt;
           AND cm.cart_type_cd = #{cartTypeCd}
          &lt;/if&gt;
          &lt;if test="searchData != null and searchData != ''"&gt;
           AND cm.cart_barcode_no LIKE CONCAT('%', #{searchData}, '%')
          &lt;/if&gt;
         ORDER BY cm.cart_id DESC
         LIMIT #{start}, #{size}
    &lt;/select&gt;
&lt;/mapper&gt;
</code></pre>

<p>둘은 <strong>이름으로 연결된다.</strong> <code>namespace</code>는 인터페이스 이름, <code>id</code>는 메서드 이름이다. <code>cartMapper.selectCartList(reqDTO)</code>를 부르면 MyBatis가 같은 이름의 SQL을 찾아 실행하고, 결과 한 줄 한 줄을 <code>CartSearchOutDTO</code>에 담아 준다.</p>

<p>SQL 컬럼은 <code>cart_barcode_no</code>인데 DTO 필드는 <code>cartBarcodeNo</code>다. <code>map-underscore-to-camel-case: true</code> 설정이 자동으로 바꿔 준다. 프론트에서 API 응답에 <code>camelcaseKeys()</code>를 쓰는 것과 같다.</p>

<hr />

<h2 id="-조건이-있을-때만-붙이기-동적-sql">③ 조건이 있을 때만 붙이기: 동적 SQL</h2>

<p>검색 조건은 있을 수도 있고 없을 수도 있다. 프론트에서는 이렇게 처리한다.</p>

<pre><code class="language-ts">const params = { subAccountId };
if (cartTypeCd) params.cartTypeCd = cartTypeCd;
if (searchData) params.searchData = searchData;
</code></pre>

<p>XML에서는 <code>&lt;if test="..."&gt;</code>가 같은 일을 한다. 조건이 참일 때만 그 줄이 SQL에 들어간다.</p>

<p><code>IN (1, 2, 3)</code>처럼 목록을 넣을 때는 <code>&lt;foreach&gt;</code>를 쓴다.</p>

<pre><code class="language-xml">AND cm.cart_id IN
&lt;foreach collection="cartIds" item="cartId" separator="," open="(" close=")"&gt;
    #{cartId}
&lt;/foreach&gt;
</code></pre>

<pre><code class="language-ts">`IN (${cartIds.map(() =&gt; '?').join(',')})`   // 하는 일은 같다
</code></pre>

<hr />

<h2 id="-와--이것만은-꼭-기억">④ <code>#{}</code>와 <code>${}</code>: 이것만은 꼭 기억</h2>

<p><code>#{searchData}</code>는 값을 SQL에 <strong>문자열로 이어 붙이지 않는다.</strong> SQL 모양을 먼저 확정해 두고, 값은 <code>?</code> 자리에 데이터로만 따로 넘긴다.</p>

<pre><code class="language-sql">WHERE cm.cart_barcode_no LIKE CONCAT('%', ?, '%')     -- 값은 따로 전달
</code></pre>

<p>그래서 사용자가 무엇을 입력해도 SQL 문법으로 해석되지 않는다.</p>

<p><code>${}</code>는 반대로 입력을 <strong>그대로 이어 붙인다.</strong> 프론트로 치면 이런 차이다.</p>

<pre><code class="language-ts">el.textContent = userInput;   // #{} : 글자로만 들어간다
el.innerHTML  = userInput;    // ${} : 입력이 코드로 실행될 수 있다 (XSS)
</code></pre>

<p>이 레포의 매퍼 XML 65개를 전부 검색해 봤더니 <code>${}</code>는 <strong>0개</strong>였다. 일부러 쓰지 않는다는 뜻이다.</p>

<hr />

<h2 id="-페이징의-함정-같은-연결이어야-한다">⑤ 페이징의 함정: 같은 연결이어야 한다</h2>

<p>목록 화면에는 “전체 N건”도 필요하다. 레거시는 MySQL 기능으로 이걸 구한다.</p>

<pre><code class="language-sql">SELECT SQL_CALC_FOUND_ROWS ... LIMIT 0, 20    -- 20건만 가져오되, LIMIT이 없었다면 몇 건인지 기억해 둬
SELECT FOUND_ROWS()                            -- 방금 기억한 숫자를 줘
</code></pre>

<pre><code class="language-java">@Service
@Transactional(readOnly = true)
public class CartService {

    public PageDTO&lt;List&lt;CartSearchOutDTO&gt;&gt; searchCartList(CartSearchReqDTO reqDTO) {
        List&lt;CartSearchOutDTO&gt; dataList = cartMapper.selectCartList(reqDTO);   // 쿼리 1
        pageDTO.setTotCnt(commMapper.getTotCnt());                              // 쿼리 2: FOUND_ROWS()
</code></pre>

<p><code>FOUND_ROWS()</code>는 <strong>같은 DB 연결에서</strong> 바로 전에 실행한 쿼리의 결과를 기억한다. 그래서 쿼리 1과 쿼리 2가 같은 연결을 써야 맞는 숫자가 나온다.</p>

<p>그걸 보장하는 게 5편에서 배운 <code>@Transactional</code>이다. 트랜잭션 안에서는 메서드가 끝날 때까지 연결 하나를 붙잡고 쓴다. 트랜잭션이 롤백 말고도 하는 일이 하나 더 있었다.</p>

<hr />

<h2 id="-레거시에서-보이는-것">⑥ 레거시에서 보이는 것</h2>

<p>6편에서 본 “빈약한 모델”이 여기 그대로 있다.</p>

<ul>
  <li>DTO에는 필드와 getter, setter만 있다.</li>
  <li><code>delete_yn = 'N'</code>(삭제 안 된 것만 보기) 같은 규칙을 <strong>쿼리마다 직접</strong> 적어야 한다. 하나만 빠뜨려도 삭제된 카트가 화면에 나온다.</li>
  <li>상태를 바꾸려면 UPDATE문을 직접 써서 호출해야 한다.</li>
</ul>

<pre><code class="language-xml">&lt;update id="updateDeleteYnCartContainerDtl"&gt;
    UPDATE cart_container_dtl
       SET delete_yn = 'Y', upd_dt = now(), upd_id = #{userId}
     WHERE cart_id = #{cartId}
&lt;/update&gt;
</code></pre>

<p>신규 기능을 JPA와 도메인 모델로 만드는 이유가 여기서 이해됐다. MyBatis가 나빠서가 아니라 <strong>규칙이 SQL에 흩어지면 테스트하기 어렵기 때문이다.</strong> 8편에서 본 것처럼 Entity 안의 규칙은 순수 Java로 바로 테스트할 수 있다. 반면 XML 속 <code>WHERE</code> 조건은 DB를 띄워야만 확인할 수 있다.</p>

<hr />

<h2 id="퀴즈-풀어-보기">퀴즈 풀어 보기</h2>

<h3 id="문제-1-로-바꾸고-이상한-값을-넣으면">문제 1: <code>${}</code>로 바꾸고 이상한 값을 넣으면?</h3>

<pre><code class="language-xml">AND cm.cart_barcode_no LIKE CONCAT('%', '${searchData}', '%')
</code></pre>

<p>검증되지 않은 값이 들어가서 오류가 날 거라고 답했다. 위험하다는 건 맞혔지만 결과는 틀렸다. <strong>오류가 나지 않는다.</strong> 그래서 더 위험하다.</p>

<p>검색창에 <code>') OR 1=1 -- </code>를 넣으면 SQL이 이렇게 바뀐다.</p>

<pre><code class="language-sql">WHERE cm.delete_yn = 'N'
  AND cm.sub_account_id = 5
  AND cm.cart_barcode_no LIKE CONCAT('%', '') OR 1=1 -- ', '%')
                                                     ↑ 이 뒤는 전부 주석 처리
</code></pre>

<p><code>AND</code>가 <code>OR</code>보다 먼저 계산되니까 결국 <code>(앞의 조건들) OR 1=1</code>이 된다. <code>1=1</code>은 항상 참이라서 <strong>다른 창고의 카트까지 전부</strong> 조회된다. 화면에는 에러 없이 데이터가 잘 나오니 아무도 눈치채지 못한다. 이게 SQL 인젝션이다. 차라리 오류가 났으면 다행이었을 것이다.</p>

<h3 id="문제-2-transactional을-지우면-전체-건수는">문제 2: <code>@Transactional</code>을 지우면 전체 건수는?</h3>

<p>“조회만 하는데 트랜잭션이 왜 필요해?” 하고 지웠을 때를 묻는 문제였다. 트랜잭션이 없으면 같은 트랜잭션이라는 걸 몰라서 안 된다고 답했다. 방향은 맞았지만, 정확한 원인은 트랜잭션이 아니라 <strong>같은 연결</strong>이다.</p>

<p>트랜잭션이 없으면 쿼리마다 커넥션 풀에서 연결을 빌렸다가 돌려준다. 쿼리 1과 쿼리 2가 서로 다른 연결을 쓰게 될 수 있고, 그러면 <code>FOUND_ROWS()</code>가 엉뚱한 숫자를 준다.</p>

<p>더 무서운 건 <strong>항상 틀리지는 않는다</strong>는 점이다. 풀이 우연히 같은 연결을 다시 주면 숫자가 맞는다. 로컬에서 혼자 테스트하면 멀쩡하고, 사용자가 몰리는 운영 환경에서만 가끔 전체 건수가 이상하게 나온다. 이렇게 가끔만 틀리는 버그가 가장 찾기 어렵다.</p>

<h3 id="문제-3-검색-조건이-비어-있으면-어떤-sql이-나갈까">문제 3: 검색 조건이 비어 있으면 어떤 SQL이 나갈까?</h3>

<p><code>cartTypeCd</code>는 <code>null</code>이고 <code>searchData</code>는 <code>""</code>인 요청이다. 처음엔 질문을 잘못 읽어서 <code>SELECT *</code>를 떠올렸는데, 물은 건 <code>WHERE</code> 절에 무엇이 남느냐였다.</p>

<p>두 <code>&lt;if&gt;</code>가 모두 거짓이라서 두 줄 다 빠진다.</p>

<pre><code class="language-sql">WHERE cm.delete_yn = 'N'
  AND cm.sub_account_id = #{subAccountId}
</code></pre>

<p>“이 창고의 삭제 안 된 카트 전부”다. 프론트에서 필터를 하나도 고르지 않고 조회 버튼을 누른 상황과 같다.</p>

<p><code>searchData != ''</code>까지 확인하는 이유도 알게 됐다. 프론트에서 검색창을 비워 두고 보내면 <code>null</code>이 아니라 빈 문자열이 오는 경우가 많다. 프론트에서 <code>if (searchData)</code>로 빈 문자열까지 거르는 것과 같은 습관이다.</p>

<hr />

<h2 id="정리">정리</h2>

<table>
  <thead>
    <tr>
      <th>개념</th>
      <th>한 줄 요약</th>
      <th>프론트 비유</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Mapper 인터페이스 + XML</td>
      <td><code>namespace</code>와 <code>id</code>로 메서드와 SQL을 연결한다</td>
      <td>API 함수 선언과 실제 쿼리</td>
    </tr>
    <tr>
      <td><code>resultType</code></td>
      <td>결과 한 줄을 DTO에 담는다</td>
      <td><code>camelcaseKeys(res)</code></td>
    </tr>
    <tr>
      <td><code>&lt;if&gt;</code>, <code>&lt;foreach&gt;</code></td>
      <td>조건부 SQL, 목록 SQL</td>
      <td>조건부 파라미터, <code>.map().join()</code></td>
    </tr>
    <tr>
      <td><code>#{}</code> vs <code>${}</code></td>
      <td>값으로 넘길지, 문자열로 이어 붙일지</td>
      <td><code>textContent</code> vs <code>innerHTML</code></td>
    </tr>
    <tr>
      <td><code>FOUND_ROWS()</code></td>
      <td>같은 연결이 필요해서 트랜잭션이 필수</td>
      <td>—</td>
    </tr>
  </tbody>
</table>

<p>정리하고 나니 남는 건 결국 세 가지였다. <strong>SQL을 직접 쓴다, 값은 <code>#{}</code>로 넣는다, 쿼리 두 개가 이어지면 같은 연결이 필요하다.</strong> 나머지 문법은 필요할 때 다시 찾아보면 된다.</p>

<p>다음 글은 이 시리즈의 마지막이다. 지금까지 배운 Controller, UseCase, Port, Entity, 예외, 테스트를 모아서 <strong>작은 API를 직접 만들어 볼</strong> 예정이다.</p>]]></content><author><name>OHaEuN</name></author><category term="Back-end" /><category term="백엔드 입문" /><category term="MyBatis" /><category term="SQL 인젝션" /><category term="레거시" /><category term="트랜잭션" /><summary type="html"><![CDATA[SQL을 XML에 직접 쓰는 레거시 MyBatis 코드를 따라가며 정리했다. Mapper 인터페이스와 XML의 연결, 동적 SQL, #{}와 ${}의 차이와 SQL 인젝션, 그리고 FOUND_ROWS()에 같은 DB 연결이 필요한 이유.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://ohaeun.github.io/OHaEuN/assets/posts/32/thumbnail.jpg" /><media:content medium="image" url="https://ohaeun.github.io/OHaEuN/assets/posts/32/thumbnail.jpg" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">셀카 퍼스널 컬러 진단 서비스를 만들고, 립 추천 서비스로 바꾸기까지</title><link href="https://ohaeun.github.io/OHaEuN/31" rel="alternate" type="text/html" title="셀카 퍼스널 컬러 진단 서비스를 만들고, 립 추천 서비스로 바꾸기까지" /><published>2026-11-05T15:30:00+09:00</published><updated>2026-11-05T15:30:00+09:00</updated><id>https://ohaeun.github.io/OHaEuN/31</id><content type="html" xml:base="https://ohaeun.github.io/OHaEuN/31"><![CDATA[<p><a href="https://tonebit.vercel.app">톤빛</a>은 셀카 한 장으로 퍼스널 컬러를 가늠하고, 올리브영에서 잘 팔리는 립 196색 중 내 얼굴에 어울리는 립을 골라 발라 볼 수 있는 웹 서비스다. 10월 중순에 첫 버전을 올렸고, 3주 동안 진단 서비스에서 립 추천 서비스로 성격이 바뀌었다. “정확도를 올릴 수 없다는 걸 확인하고 나서 서비스를 어떻게 바꿨는가”가 이 프로젝트의 핵심이라, 그 과정과 판단 기준을 기록해 두려고 한다.</p>

<blockquote>
  <p><strong>결과:</strong> 셀카를 올리면 내 톤이 확률과 함께 나온다. 내 얼굴에 바른 두 립 중 나은 쪽을 일곱 번 고르면, 196색 중 내 피부와 내 눈에 맞춘 순위가 나오고 바로 살 수 있다.</p>
</blockquote>

<figure class="imageblock alignCenter">
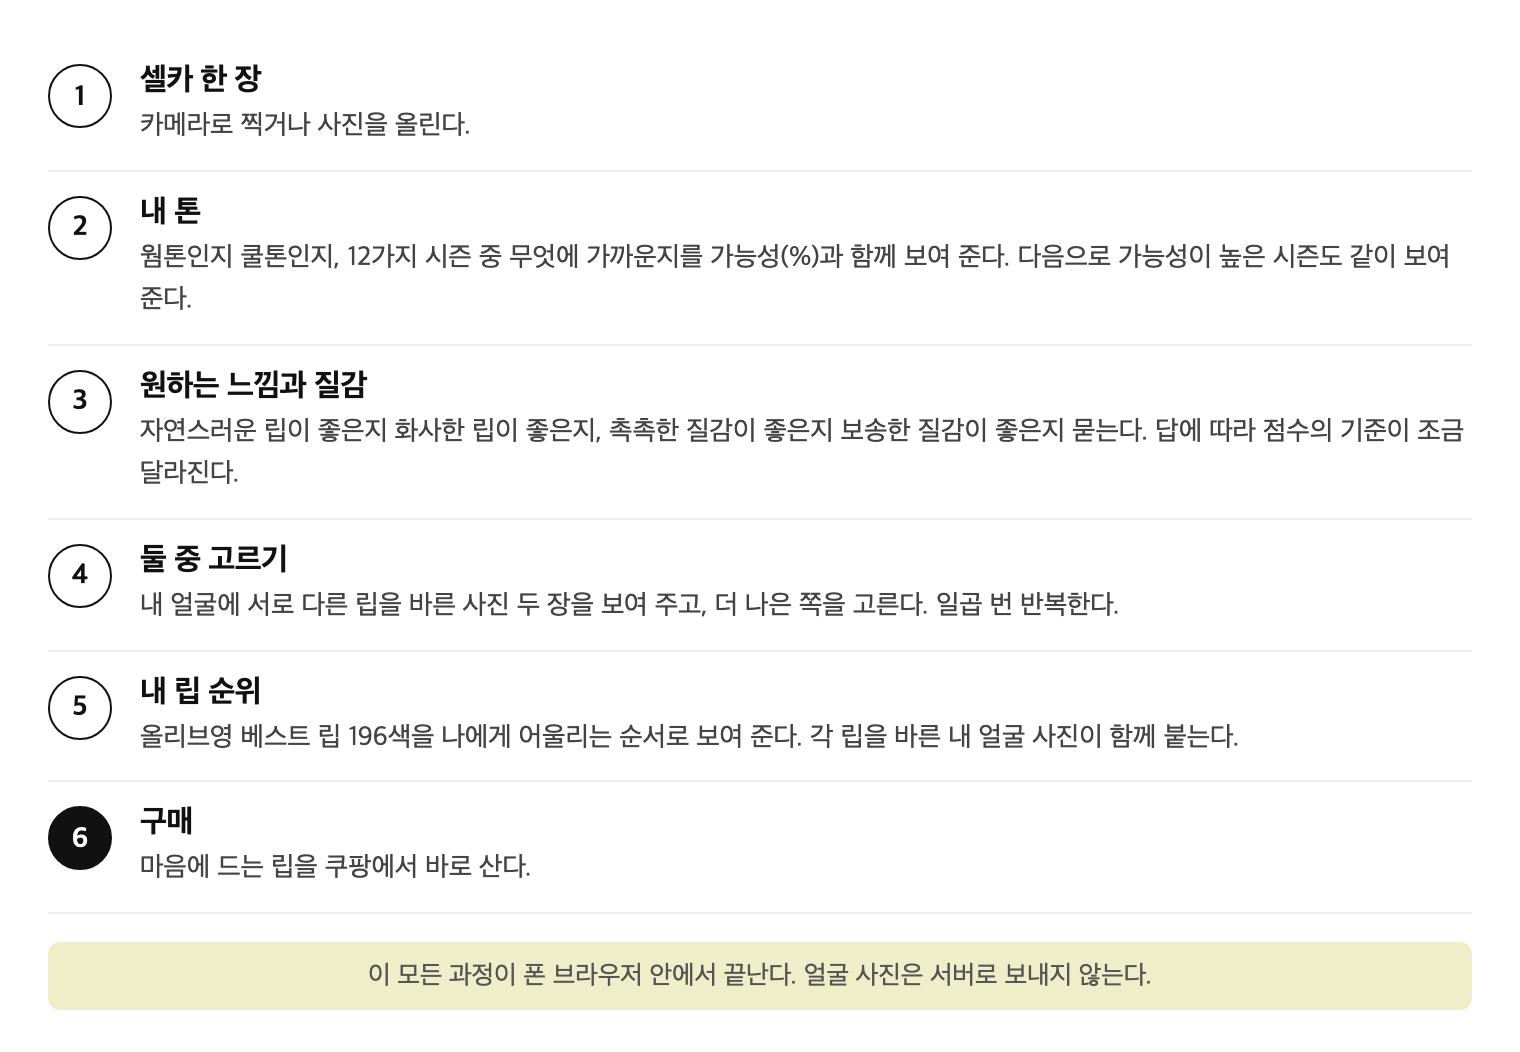
  <p><img src="/OHaEuN/assets/posts/31/flow-diagram.png" alt="톤빛의 흐름: 셀카, 내 톤, 느낌·질감, 둘 중 고르기, 내 립 순위, 구매" /></p>
</figure>

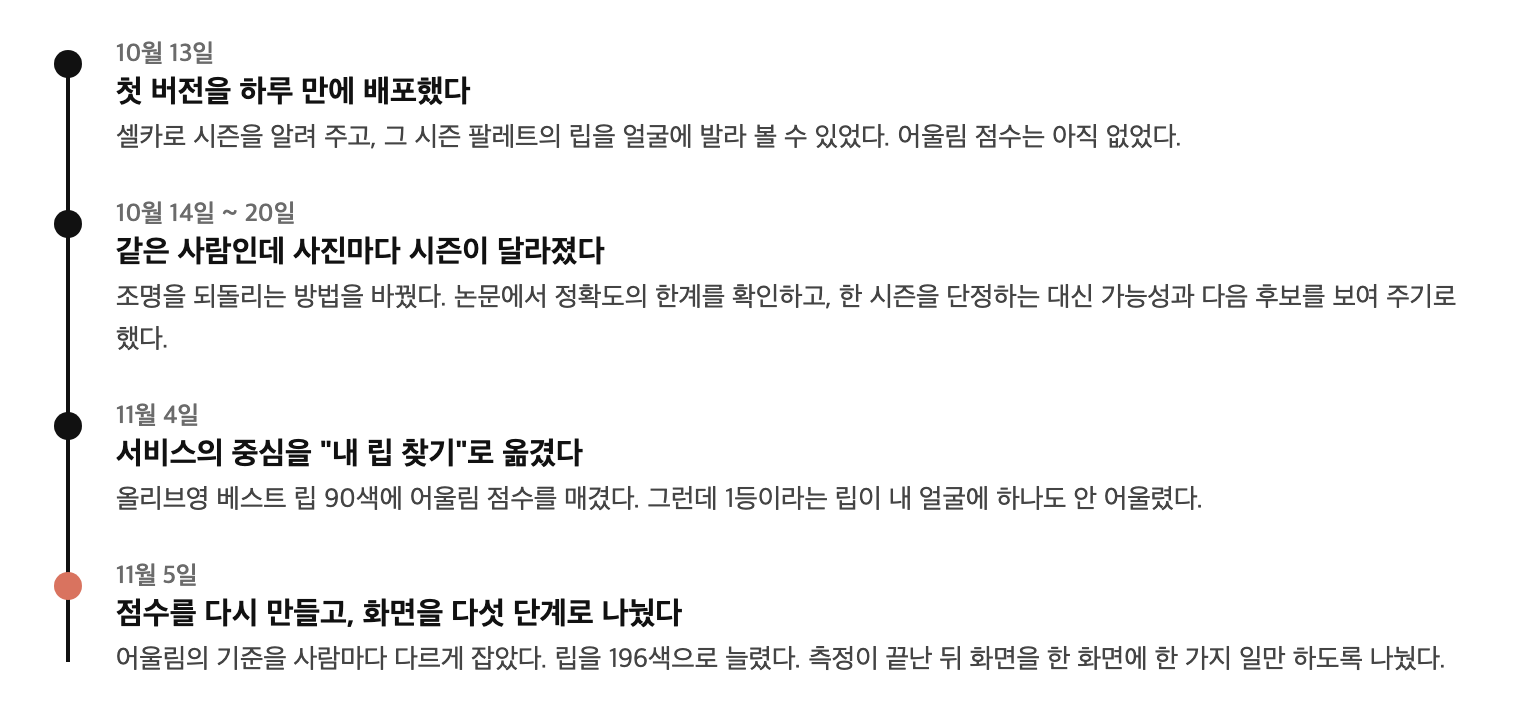
<p>3주 동안 이런 순서로 바뀌었다. 아래 글도 같은 순서로 간다.</p>

<figure class="imageblock alignCenter">
  <p><img src="/OHaEuN/assets/posts/31/timeline.png" alt="3주 타임라인" /></p>
</figure>

<hr />

<h2 id="1-왜-만들었나">1. 왜 만들었나</h2>

<p>뷰티와 유통에 관심이 있어서, 평소 궁금했던 퍼스널 컬러를 아이템으로 잡았다. 전문가 진단은 몇만 원에서 십만 원이 넘는다. 온라인 자가 진단은 설문이라 얼굴을 보지 않는다. 사진으로 봐 주는 앱은 사진을 서버로 올려야 한다. 그리고 어느 쪽이든 “당신은 여름 쿨입니다”에서 끝난다.</p>

<p>내가 만들고 싶었던 건 그 다음이었다. 진단이 “그래서 이 립을 사면 된다”까지 이어지는 서비스. 조건은 세 가지였다.</p>

<ul>
  <li>돈을 들이지 않는다. 서버 비용을 내지 않고, 광고 심사도 받지 않는다. 수익은 쿠팡 파트너스 링크로만 낸다.</li>
  <li>할 수 있는 만큼 <strong>정확하게</strong> 진단한다.</li>
  <li>진단에서 <strong>구매까지</strong> 한 흐름으로 이어지게 한다.</li>
</ul>

<p>얼굴 인식 모델(MediaPipe)이 브라우저에서 돌아가니, 사진을 서버로 보내지 않는 구조로 갈 수 있었다.</p>

<hr />

<h2 id="2-하루-만에-만든-첫-버전">2. 하루 만에 만든 첫 버전</h2>

<p>아이디어를 내고 하루 만에 바이브 코딩으로 결과물을 만들어냈다. MVP를 따로 두지 않고 처음부터 서비스 모양을 갖췄다. 공유 카드, 쿠팡 링크, 보안 설정, 자동 테스트는 나중에 붙이면 구조를 다시 짜야 해서 첫날에 넣었다.</p>

<table data-ke-align="alignLeft">
  <thead>
    <tr>
      <th>기능</th>
      <th>첫날 범위</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>측정</td>
      <td>셀카에서 얼굴을 찾아 볼과 이마 색을 읽고, 웜·쿨과 12가지 시즌 중 하나를 알려 준다</td>
    </tr>
    <tr>
      <td>발라 보기</td>
      <td>그 시즌에 맞는 립·블러셔 색을 사진 속 입술과 볼에 얹어 보여 준다</td>
    </tr>
    <tr>
      <td>결과 페이지</td>
      <td>톤마다 주소와 공유 썸네일이 있고, 제품 카드는 쿠팡으로 이어진다</td>
    </tr>
    <tr>
      <td>보안·테스트</td>
      <td>외부 연결을 막는 CSP, 가짜 카메라로 전체 흐름을 도는 Playwright 테스트</td>
    </tr>
  </tbody>
</table>

<p>제품 색은 브랜드 설명을 보고 눈대중으로 적은 값이었고, 어울림 점수는 없었다. 시즌이 나오면 그 시즌 팔레트를 발라 보는 게 전부였다.</p>

<p>배포하고 폰으로 열어 보니 바로 문제가 보였다. 아이폰에서 모델이 안 뜨고, 아이패드가 데스크톱으로 잡히고, 색을 고르는 동안 사진이 화면 밖으로 밀려났다. 그날 저녁에만 일곱 개를 고쳤다. 데스크톱 브라우저에서만 확인하고 배포한 대가였다.</p>

<hr />

<h2 id="3-진단이-사진마다-달랐다">3. 진단이 사진마다 달랐다</h2>

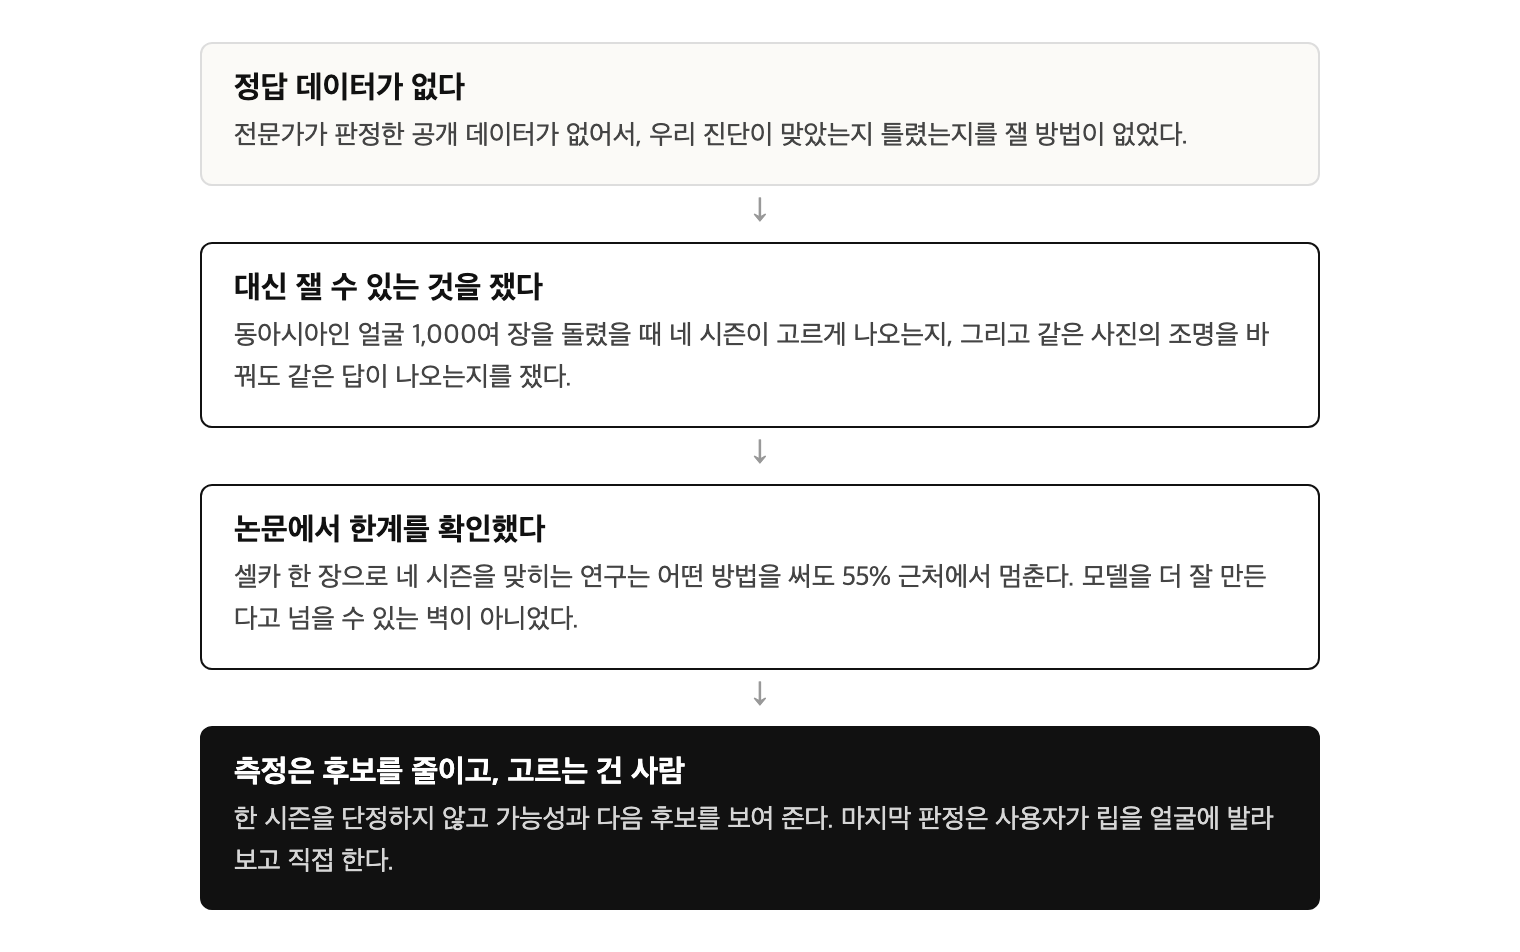
<p>며칠 써 보니 같은 사람인데 사진마다 다른 시즌이 나왔다. 전문가 진단을 받아 본 지인에게 돌려 보니 절반쯤 맞았다. 정확도를 올려야 했는데, 막상 손을 대려니 “무엇과 비교해서 정확한가”부터 정해야 했다.</p>

<figure class="imageblock alignCenter">
  <p><img src="/OHaEuN/assets/posts/31/decision.png" alt="정답 데이터가 없다 → 잴 수 있는 것을 쟀다 → 논문에서 벽을 확인했다 → 측정은 후보를 줄이고 고르는 건 사람" /></p>
</figure>

<p>잴 수 있는 두 가지를 쟀더니 둘 다 안 좋았다. 네 시즌 중 겨울이 38%로 쏠려 있었고, 조명을 바꾸면 답이 자주 바뀌었다. 쏠림은 기준값을 다시 잡아서 네 시즌이 22~28%로 고르게 나오게 했다. 조명은 보정 방법 자체를 바꿨다. 전에는 사진 전체의 평균색으로 조명을 추정했는데, 그러면 벽이나 옷 색까지 조명으로 착각한다. 지금은 얼굴 안에 있는 흰 것, 즉 치아와 눈 흰자를 기준으로 조명을 되돌린다.</p>

<table data-ke-align="alignLeft">
  <thead>
    <tr>
      <th> </th>
      <th>전</th>
      <th>후</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>조명을 바꿔도 같은 시즌이 나오는 비율</td>
      <td>84%</td>
      <td>87%</td>
    </tr>
    <tr>
      <td>같은 비율, 12타입 기준</td>
      <td>64%</td>
      <td>75%</td>
    </tr>
  </tbody>
</table>

<p>그러고 나서 논문을 찾아봤다. 셀카 한 장으로 네 시즌을 맞히는 연구는 방법이 달라도 전부 55% 근처에서 멈춘다. 모델을 더 잘 만든다고 넘을 수 있는 벽이 아니었다. 그래서 한 시즌을 단정하지 않고 확률과 다음 후보를 같이 보여 주기로 했다. 마지막 판정은 사용자 눈에 맡긴다. 두 색을 번갈아 발라 보고 고르는 “셀프 비교”가 여기서 나왔다.</p>

<blockquote data-ke-style="style1">
  <p>판단 기준: <strong>측정은 후보를 줄이는 역할이고, 고르는 건 사람이다.</strong> <br />이 뒤의 결정은 전부 이 기준에서 나왔다.</p>
</blockquote>

<hr />

<h2 id="4-어울린다는-립이-하나도-안-어울렸다">4. 어울린다는 립이 하나도 안 어울렸다</h2>

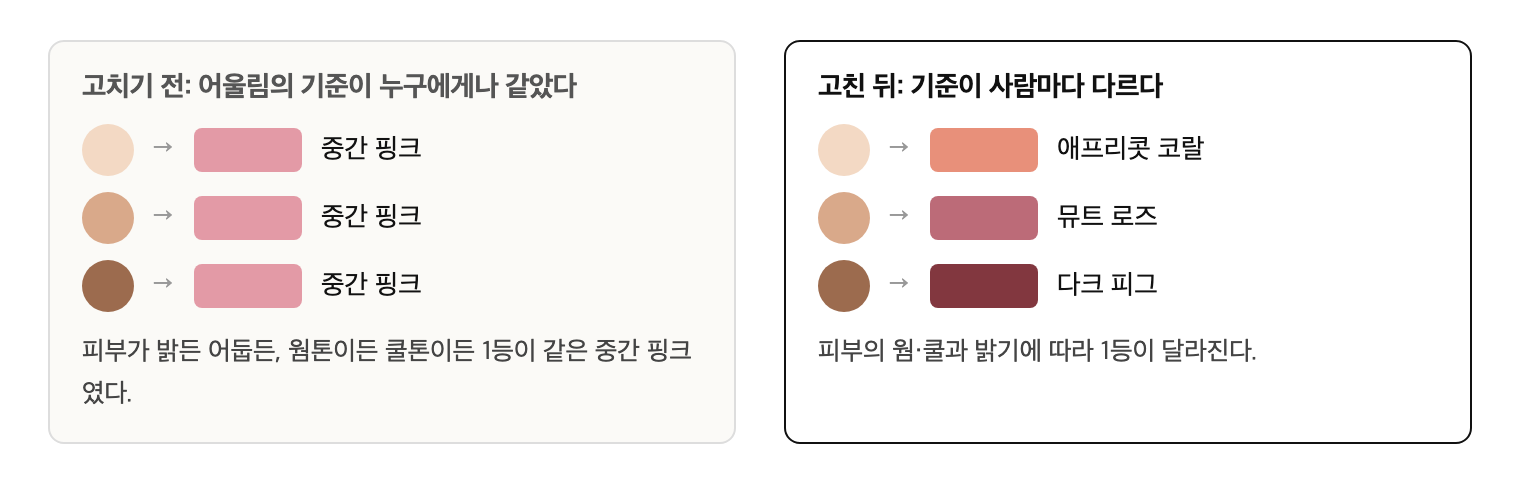
<p>서비스 중심을 “내 립 찾기”로 옮기고, 올리브영 베스트셀러 립 90색에 어울림 점수를 매겼다. 그런데 내 얼굴로 돌려 보니 1등이라는 립이 하나도 안 어울렸다. 점수를 세 번 다시 만들었다.</p>

<table data-ke-align="alignLeft">
  <thead>
    <tr>
      <th> </th>
      <th>방식</th>
      <th>문제</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>첫 번째</td>
      <td>립은 피부보다 어둡게, 색은 피부에서 너무 멀지 않게, 채도는 비슷하게. 연구 규칙을 그대로 옮김</td>
      <td>조건을 어느 정도 만족하면 전부 100점</td>
    </tr>
    <tr>
      <td>두 번째</td>
      <td>가장 알맞은 지점에서 멀어질수록 깎이게</td>
      <td>100점은 사라졌지만 여전히 안 어울림</td>
    </tr>
    <tr>
      <td><strong>세 번째</strong></td>
      <td><strong>가장 알맞은 지점을 사람마다 다르게</strong></td>
      <td>피부색이 다른 얼굴 넷의 1등이 전부 달라짐</td>
    </tr>
  </tbody>
</table>

<figure class="imageblock alignCenter">
  <p><img src="/OHaEuN/assets/posts/31/score-before-after.png" alt="두 번째 점수까지는 피부색이 달라도 1등이 같은 중간 핑크, 세 번째 점수는 사람마다 다른 1등" /></p>
</figure>

<p>두 번째까지 안 어울렸던 이유는 “가장 알맞은 지점”이 모든 사람에게 같았기 때문이다. 세 번째 점수는 그 지점을 사람마다 다르게 잡는다. 쿨톤이면 핑크 쪽 색이, 웜톤이면 코랄 쪽 색이 기준점이 된다. 피부가 밝은 라이트 타입이면 연한 립이, 어두운 딥 타입이면 진한 립이 기준점이 된다. 비교할 때는 제품 색 그대로가 아니라 “이 사람 입술에 발랐을 때 보일 색”을 쓴다.</p>

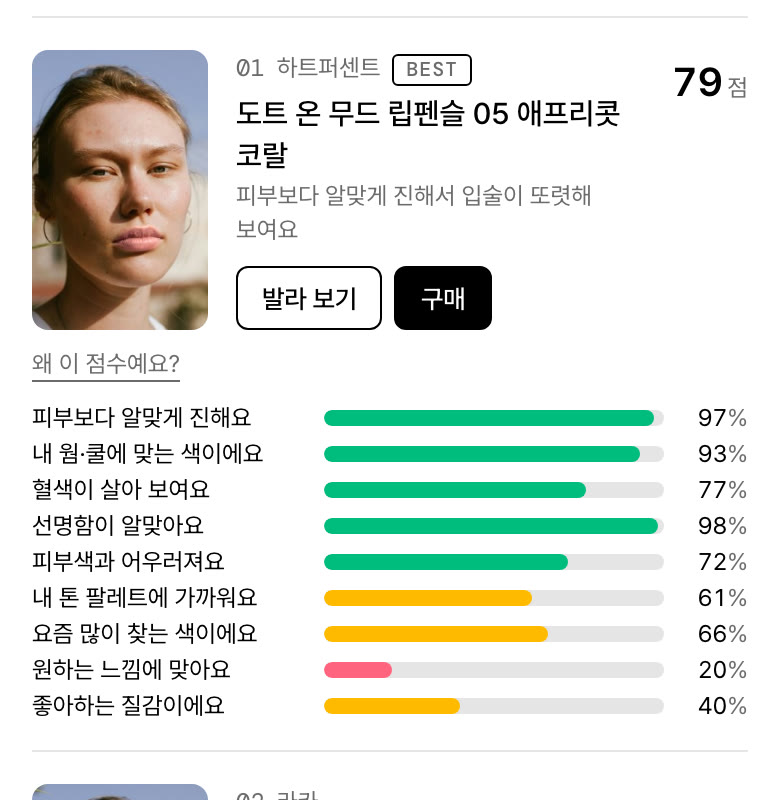
<p>점수를 매기는 기준은 아홉 가지다.</p>

<table data-ke-align="alignLeft">
  <thead>
    <tr>
      <th>기준</th>
      <th>무엇을 보나</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>진하기</td>
      <td>립이 피부보다 알맞게 진한가</td>
    </tr>
    <tr>
      <td>웜·쿨 방향</td>
      <td>내 톤 방향(코랄 쪽 또는 핑크 쪽)의 색인가</td>
    </tr>
    <tr>
      <td>혈색</td>
      <td>발랐을 때 혈색이 살아 보이는가</td>
    </tr>
    <tr>
      <td>선명함</td>
      <td>피부에 비해 너무 선명하거나 흐리지 않은가</td>
    </tr>
    <tr>
      <td>피부와의 조화</td>
      <td>피부색과 립 색이 어우러지는가</td>
    </tr>
    <tr>
      <td>내 톤 팔레트</td>
      <td>내 시즌 팔레트의 색에 가까운가</td>
    </tr>
    <tr>
      <td>유행</td>
      <td>요즘 많이 찾는 색인가 (올리브영 월간 베스트 순위)</td>
    </tr>
    <tr>
      <td>원하는 느낌</td>
      <td>내가 답한 느낌(자연스러운, 화사한, 또렷한)에 맞는가</td>
    </tr>
    <tr>
      <td>질감</td>
      <td>내가 좋아한다고 답한 질감인가</td>
    </tr>
  </tbody>
</table>

<p>바꾼 뒤 피부색이 다른 얼굴 넷으로 전체 제품의 점수를 뽑아 봤다. 1등이 체리 레드, 뮤트 로즈, 브릭 레드, 다크 피그로 전부 달랐고, 1등은 80점대, 중간은 60~70점대다. 100점은 없다. 이 결과는 자동 테스트로 적어 두어서, 나중에 점수를 고쳤다가 웜과 쿨의 1등이 다시 같아지면 테스트가 실패한다.</p>

<h3 id="제품-색은-직접-뽑았다">제품 색은 직접 뽑았다</h3>

<p>한국 브랜드 립 색을 무료로 주는 데이터는 없었다. 쇼핑몰을 크롤링하면 약관 문제도 있고 색의 출처를 설명할 수 없다. 대신 브랜드 공식 사이트의 색상 칩과 발색 사진에서 색을 직접 뽑았다. 196색 중 173색이 이렇게 잰 값이고, 색마다 출처를 적어 뒀다.</p>

<h3 id="발색이-스티커-같았다">발색이 스티커 같았다</h3>

<p>립을 얹는 렌더링도 두 번 갈아엎었다. 처음에는 제품 색을 반투명하게 덮었는데 밝은 제품이 형광처럼 떴다. 색을 덜 올리니 이번엔 묽어지고, 입술의 반짝이는 부분까지 색이 덮여서 스티커 같았다. 지금은 밝기, 반짝임, 명암을 따로 다룬다. 밝기는 일부만 옮기고, 원래 반짝이던 자리에는 색을 덜 묻히고, 밝게 띄울수록 명암 폭을 같이 키운다.</p>

<figure class="imageblock alignCenter">
  <p><img src="/OHaEuN/assets/posts/31/tryon.gif" alt="같은 얼굴에 립 다섯 가지를 차례로 발라 본 모습" width="240" /></p>
</figure>

<hr />

<h2 id="5-측정-뒤-화면을-다섯-단계로">5. 측정 뒤 화면을 다섯 단계로</h2>

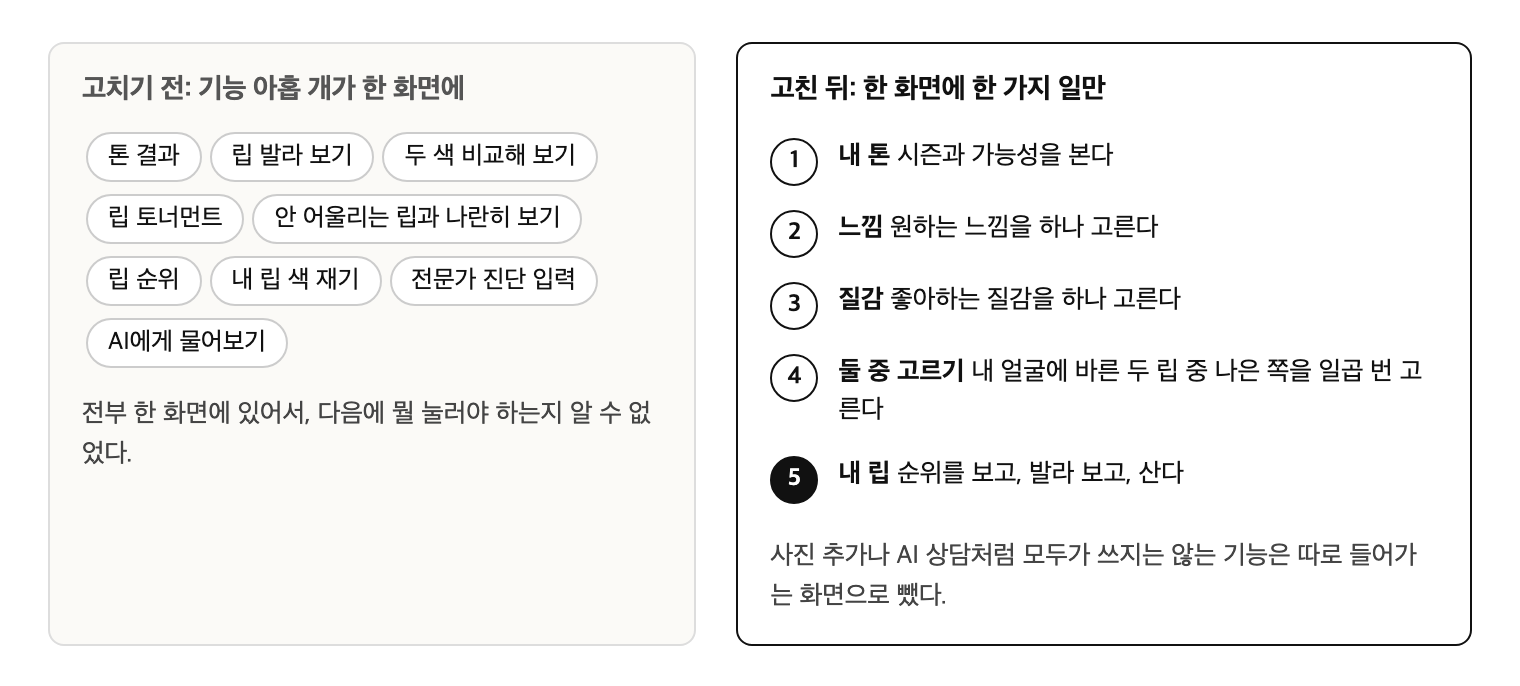
<p>기능이 늘어나는 동안 측정 뒤 화면은 쌓이기만 했다. 만든 나도 다음에 뭘 눌러야 하는지 몰랐다. 한 화면에 한 가지 일만 두기로 하고 다섯 단계로 나눴다. 모두가 쓰지 않는 기능은 곁가지로 뺐다.</p>

<figure class="imageblock alignCenter">
  <p><img src="/OHaEuN/assets/posts/31/screens-before-after.png" alt="전: 한 화면에 아홉 가지. 후: 다섯 단계와 곁가지 둘" /></p>
</figure>

<figure class="imageblock alignCenter">
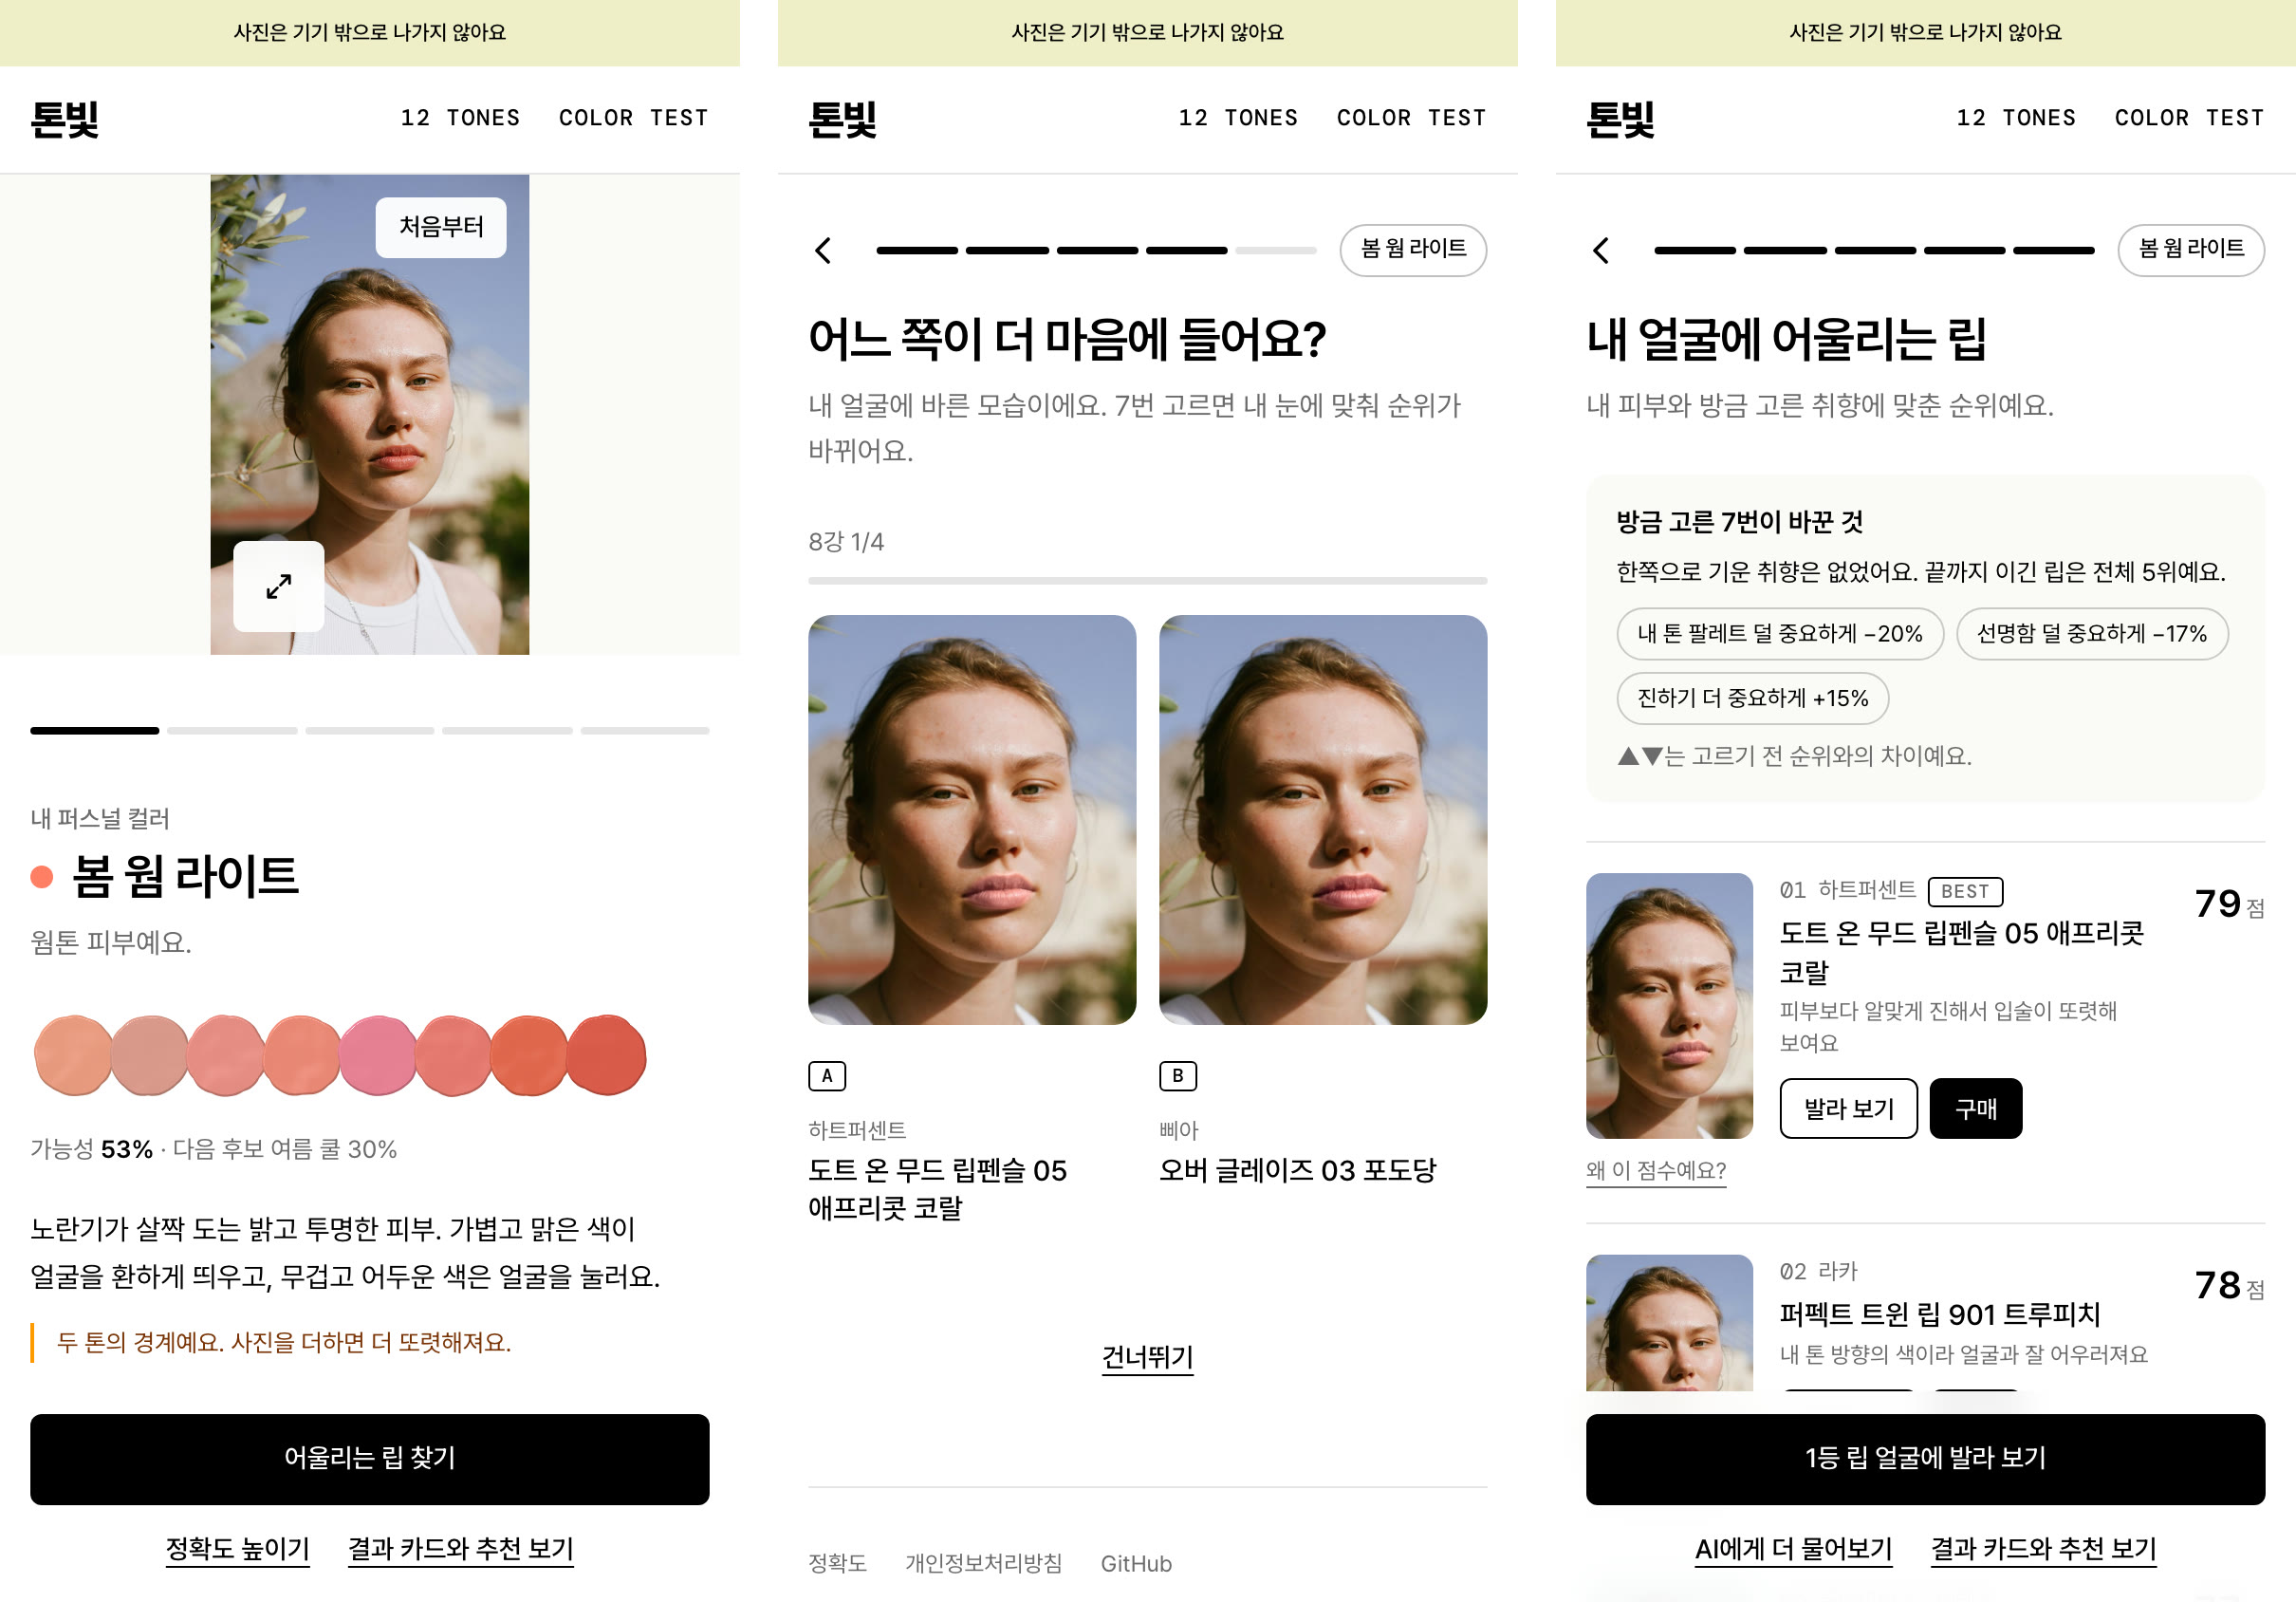
  <p><img src="/OHaEuN/assets/posts/31/flow.jpg" alt="내 톤, 둘 중 고르기, 내 립 화면" /></p>
</figure>

<p>폰에서 쓰는 걸 기본으로 놓았다. 뒤로 가기는 브라우저 뒤로 가기와 같아서, 뒤로 스와이프하면 이전 단계로 돌아간다. 사진은 질문 화면에서 숨기고, 내 톤 화면에서는 작게, 발라 보기에서만 위에 고정했다. 진행 막대와 다음 버튼은 화면 아래에 붙여 엄지로 바로 닿는다.</p>

<h3 id="둘-중-고르기-내-눈으로-고른-결과가-순위에-들어간다">둘 중 고르기: 내 눈으로 고른 결과가 순위에 들어간다</h3>

<p>“측정은 후보를 줄이고 고르는 건 사람”이라는 기준을 제품에도 적용한 게 둘 중 고르기다. 점수 상위에서 서로 다른 8색을 뽑아 내 얼굴에 바른 사진을 두 장씩 보여 주고, 더 나은 쪽을 고른다. 일곱 번 고르면 끝까지 이긴 립에 “내 1등”이 붙는다. 고른 결과는 점수에도 들어간다. 내가 고른 쪽이 더 높은 점수를 받도록 아홉 기준의 비중을 조금씩 옮기는 식이다.</p>

<p>처음엔 기준을 전부 움직이게 했더니 일곱 번 고른 걸로 작은 항목 하나가 −70%까지 튀었다. 일곱 번은 아홉 개를 정하기엔 너무 적어서 우연에 맞춰진 것이었다. 지금은 진하기, 웜·쿨 방향, 혈색, 선명함, 시즌 팔레트 다섯 가지만 움직인다.</p>

<h3 id="직접-써-보고-고친-것">직접 써 보고 고친 것</h3>

<p>여기까지 만들고 처음부터 끝까지 직접 써 봤다. 기능은 다 있는데 “이게 뭐지?” 싶은 데가 세 군데 나왔다.</p>

<table data-ke-align="alignLeft">
  <thead>
    <tr>
      <th>써 보니 걸린 것</th>
      <th>바꾼 것</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>진단이 끝났는데 <strong>내 퍼스널 컬러가 뭔지</strong> 한눈에 안 들어왔다. 사진이 화면을 거의 다 차지하고, 시즌 이름은 그 밑에 작게 있었다.</td>
      <td>폰에서는 사진을 줄이고, 그 자리에 “내 퍼스널 컬러”라는 제목과 시즌 색 점, 웜톤인지 쿨톤인지 한 문장을 올렸다. 다음 화면부터는 오른쪽 위에 “봄 웜 라이트” 같은 표시가 계속 따라다닌다.</td>
    </tr>
    <tr>
      <td>둘 중 고르기를 일곱 번 하고 나서도 <strong>그게 결과에 뭘 바꿨는지</strong> 알 수 없었다. 그냥 순위가 나올 뿐이었다.</td>
      <td>순위 맨 위에 “방금 고른 7번이 바꾼 것”이라는 상자를 뒀다. 내가 고른 경향을 “더 진한 색을 골랐어요”처럼 한 줄로 말해 주고, 비중이 어떻게 바뀌었는지를 “진하기 더 중요하게 +16%”처럼 보여 주고, 각 순위 옆에 고르기 전보다 몇 계단 오르내렸는지 ▲▼로 붙였다.</td>
    </tr>
    <tr>
      <td><strong>항목별 점수가 안 읽혔다.</strong> 막대가 작고 전부 검은색이었고, 항목 이름이 “치아”, “인상”처럼 무슨 뜻인지 알 수 없는 말이었다.</td>
      <td>항목 이름을 버리고 “피부보다 알맞게 진해요” 같은 문장으로 바꿨다. 막대는 키우고, 점수에 따라 초록·노랑·분홍으로 칠하고, 퍼센트를 붙였다. “치아” 항목은 누구에게나 차가운 색을 조금씩 밀어 주는 항목이라 아예 뺐다.</td>
    </tr>
    <tr>
      <td><strong>화면마다 글이 너무 많았다.</strong> 모든 화면 아래에 같은 안내문과 측정 숫자가 반복됐고, “확신도”, “보정 기준” 같은 말이 그대로 노출됐다.</td>
      <td>반복되는 안내는 내 톤 화면과 정확도 높이기 화면에만 남기고, 용어와 같은 말의 두 번째 문장을 뺐다. 글자 크기는 그대로 두고, 한 화면에 꼭 필요한 문장만 남겼다.</td>
    </tr>
  </tbody>
</table>

<figure class="imageblock alignCenter">
  <p><img src="/OHaEuN/assets/posts/31/bars.jpg" alt="내 립 화면의 항목별 막대" width="390" /></p>
</figure>

<hr />

<h2 id="6-결과">6. 결과</h2>

<table data-ke-align="alignLeft">
  <thead>
    <tr>
      <th> </th>
      <th>첫 버전 (10월 13일)</th>
      <th>지금</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>진단</td>
      <td>한 시즌을 단정</td>
      <td>확률과 다음 후보, 근거 문장. 최종 판정은 사용자의 눈</td>
    </tr>
    <tr>
      <td>립</td>
      <td>시즌 팔레트를 발라 보는 것까지</td>
      <td>196색 순위, 그 립을 바른 내 얼굴, 구매 링크</td>
    </tr>
    <tr>
      <td>점수</td>
      <td>없음</td>
      <td>아홉 가지 기준, 사람마다 다른 기준점, 내 선택으로 비중 조정</td>
    </tr>
    <tr>
      <td>제품 색</td>
      <td>눈대중</td>
      <td>173색을 브랜드 공식 칩·발색에서 실측</td>
    </tr>
    <tr>
      <td>화면</td>
      <td>탭 하나에 전부</td>
      <td>다섯 단계, 곁가지 둘</td>
    </tr>
  </tbody>
</table>

<hr />

<h2 id="마치며">마치며</h2>

<p>처음 목표는 진단에서 구매까지 한 줄로 이어지는 서비스였지, 진단을 잘하는 것 자체는 아니었다. 정확도 55%라는 벽은 넘지 못했지만, 그 벽 덕분에 “측정은 후보를 줄이고 고르는 건 사람”이라는 흐름이 생겼다. 돌아보면 그게 처음 의도에 더 가까웠다. 진단 결과를 통보받는 것보다, 내 얼굴에 발라 본 두 립 중 하나를 고르는 쪽이 구매까지 훨씬 자연스럽게 이어진다.</p>

<p>개인적으로 가장 잘한 결정은 점수를 두 번째로 고쳤을 때 분포가 예뻐졌는데도 “그래도 안 어울린다”를 그냥 넘기지 않은 것이다. 숫자가 괜찮아 보여도 내 얼굴로 써 보면 바로 티가 났다. 그 느낌을 “피부색이 다른 얼굴 셋에서 1등이 같으면 안 된다”는 기준으로 바꾸고 나서야 고칠 수 있었다.</p>

<p>다음은 이 흐름이 정말 구매로 이어지는지 숫자로 보는 일이다. 측정을 마쳤는지, 둘 중 고르기를 끝냈는지, 어느 화면에서 몇 위 제품의 구매 링크를 눌렀는지를 남기고 있으니, 쌓이면 어디서 끊기는지부터 볼 생각이다.</p>

<h2 id="참고">참고</h2>

<ul>
  <li>Kärkkäinen, K., &amp; Joo, J. (2021). FairFace. WACV.</li>
  <li>Choi, K., Choi, J., &amp; Suk, H.-J. (2017). The human sclera and pupil as the calibration targets. IS&amp;T Electronic Imaging.</li>
  <li>Hirayama, H. 외 (1998). 립 컬러와 피부색의 조화에 관한 연구. 粧技誌 32(2).</li>
  <li>Ou, L.-C., &amp; Luo, M. R. (2006). A colour harmony model for two-colour combinations. Color Research &amp; Application 31(3).</li>
  <li>코드와 수치 전체: <a href="https://github.com/OHaEuN/tonebit">github.com/OHaEuN/tonebit</a>의 <code>docs/color-analysis.md</code>, <code>docs/lip.md</code>.</li>
</ul>]]></content><author><name>OHaEuN</name></author><category term="Front-end" /><category term="톤빛" /><category term="퍼스널 컬러" /><category term="사이드 프로젝트" /><category term="UX" /><category term="MediaPipe" /><category term="Next.js" /><summary type="html"><![CDATA[셀카 한 장으로 퍼스널 컬러를 가늠하는 서비스를 만들었다가, 3주 만에 '내 얼굴에 맞는 립을 골라 주는' 서비스로 방향을 바꿨다. 왜 시작했고, 어디서 막혔고, 무엇을 기준으로 바꿨는지 정리했다.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://ohaeun.github.io/OHaEuN/assets/posts/31/thumbnail.jpg" /><media:content medium="image" url="https://ohaeun.github.io/OHaEuN/assets/posts/31/thumbnail.jpg" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">[백엔드 입문 #8] JUnit과 Mockito로 도메인, UseCase, 통합 테스트 작성하기</title><link href="https://ohaeun.github.io/OHaEuN/30" rel="alternate" type="text/html" title="[백엔드 입문 #8] JUnit과 Mockito로 도메인, UseCase, 통합 테스트 작성하기" /><published>2026-11-04T17:35:00+09:00</published><updated>2026-11-04T17:35:00+09:00</updated><id>https://ohaeun.github.io/OHaEuN/30</id><content type="html" xml:base="https://ohaeun.github.io/OHaEuN/30"><![CDATA[<p>프론트에서 테스트라고 하면 이런 코드를 떠올린다.</p>

<pre><code class="language-ts">describe('formatPrice', () =&gt; {
  it('천 단위에 콤마를 붙인다', () =&gt; {
    expect(formatPrice(12000)).toBe('12,000');
  });
});
</code></pre>

<p>백엔드 테스트도 생각은 같다. 다만 백엔드에서는 테스트가 훨씬 더 중요하다는 걸 이번에 알았다.</p>

<ul>
  <li><strong>눌러 볼 화면이 없다.</strong> 프론트는 브라우저에서 버튼을 눌러 보면 된다. 하지만 “취소된 출고는 출하 불가” 같은 규칙을 직접 확인하려면 DB에 데이터를 넣고, 서버를 띄우고, API를 호출해야 한다.</li>
  <li><strong>서버 재시작이 느리다.</strong> 서버를 한 번 띄우는 데 수십 초가 걸린다. 테스트는 0.1초면 끝난다.</li>
  <li><strong>틀리면 창고에서 물건이 잘못 움직인다.</strong> <a href="/OHaEuN/28">지난 글</a>들에서 본 중복 재고 차감 같은 사고가 난다.</li>
</ul>

<blockquote>
  <p>글에 나오는 코드는 이해를 돕기 위해 일부 단순화했다.</p>
</blockquote>

<hr />

<h2 id="-테스트는-세-층으로-나뉜다">① 테스트는 세 층으로 나뉜다</h2>

<pre><code>          ▲  느림, 적게
         ╱ ╲
        ╱통합╲      FeatureFlagIntegrationTest  ← 진짜 Spring + DB + HTTP
       ╱─────╲
      ╱UseCase╲     DeleteFeatureFlagTest       ← Port를 가짜(Mock)로
     ╱─────────╲
    ╱  도메인   ╲    FeatureFlagTest, OutboundTest ← 순수 Java, 아무것도 없이
   ╱─────────────╲
          ▼  빠름, 많이
</code></pre>

<table>
  <thead>
    <tr>
      <th>층</th>
      <th>무엇을 확인하나</th>
      <th>필요한 것</th>
      <th>프론트 비유</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>도메인</td>
      <td>Entity 규칙 (<code>delete</code>, <code>endPicking</code>)</td>
      <td>없음</td>
      <td>순수 함수 테스트</td>
    </tr>
    <tr>
      <td>UseCase</td>
      <td>순서와 조립 (조회 → 검증 → 저장)</td>
      <td>Mockito</td>
      <td>MSW로 API를 가짜로 바꾸고 훅 테스트</td>
    </tr>
    <tr>
      <td>통합</td>
      <td>HTTP 요청이 DB까지 실제로 가나</td>
      <td>Spring, DB</td>
      <td>Playwright E2E</td>
    </tr>
  </tbody>
</table>

<p>1편에서 배운 <strong>Port</strong>가 여기서 쓸모를 보여 준다. UseCase는 DB를 직접 모르고 인터페이스만 안다. 그래서 테스트에서는 그 자리에 가짜를 끼우면 되고, DB 없이도 UseCase를 테스트할 수 있다.</p>

<hr />

<h2 id="-도메인-테스트-가장-쉽고-가장-많다">② 도메인 테스트: 가장 쉽고 가장 많다</h2>

<pre><code class="language-java">@DisplayName("FeatureFlag 도메인")                // describe
class FeatureFlagTest {

    @Nested
    @DisplayName("delete")                        // 중첩 describe
    class Delete {

        @Test
        @DisplayName("삭제하면 deletedAt과 updatedBy가 설정된다")   // it
        void deletesFeatureFlag() {
            // given
            FeatureFlag featureFlag = offFeatureFlag();

            // when
            featureFlag.delete(DELETED_BY);

            // then
            assertThat(featureFlag.getDeletedAt()).isNotNull();
            assertThat(featureFlag.getUpdatedBy()).isEqualTo(DELETED_BY);
        }
    }
}
</code></pre>

<p>생김새만 다르고 Jest와 거의 일대일로 대응된다.</p>

<table>
  <thead>
    <tr>
      <th>JUnit + AssertJ</th>
      <th>Jest</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><code>@DisplayName("...")</code> + 클래스</td>
      <td><code>describe('...')</code></td>
    </tr>
    <tr>
      <td><code>@Nested</code></td>
      <td>중첩 <code>describe</code></td>
    </tr>
    <tr>
      <td><code>@Test</code> + <code>@DisplayName</code></td>
      <td><code>it('...')</code></td>
    </tr>
    <tr>
      <td><code>assertThat(x).isEqualTo(y)</code></td>
      <td><code>expect(x).toBe(y)</code></td>
    </tr>
    <tr>
      <td><code>assertThat(x).isNotNull()</code></td>
      <td><code>expect(x).not.toBeNull()</code></td>
    </tr>
  </tbody>
</table>

<p><code>// given / when / then</code> 주석은 준비, 실행, 확인 단계를 나눠 보여 준다. 팀 컨벤션으로 아예 필수로 정해 둔 곳도 있다. 테스트가 길어져도 어디까지가 준비 단계인지 바로 보인다.</p>

<p>예외가 나는지는 이렇게 확인한다.</p>

<pre><code class="language-java">@Test
@DisplayName("ON 상태면 ActiveFeatureFlagException을 던진다")
void throwsWhenOn() {
    FeatureFlag featureFlag = onFeatureFlag();

    assertThatThrownBy(() -&gt; featureFlag.validateModifiable(flag -&gt; List.of()))
        .isInstanceOf(ActiveFeatureFlagException.class);
}
</code></pre>

<pre><code class="language-ts">expect(() =&gt; flag.validateModifiable()).toThrow(ActiveFeatureFlagError);
</code></pre>

<p><a href="/OHaEuN/29">지난 글</a>에서 예외를 클래스별로 나눠 만든 이유가 여기서 하나 더 보였다. 어떤 예외가 나야 하는지를 클래스로 정확히 검증할 수 있다.</p>

<p>도메인 테스트에는 Spring도, DB도, Mock도 없다. 객체를 만들고 메서드를 부르고 결과를 본다. 이렇게 단순할 수 있는 건 <strong>규칙을 Entity 안에 뒀기 때문이다.</strong> 규칙이 Service와 SQL에 흩어져 있었다면 하나를 확인하는 데도 DB가 필요했을 것이다.</p>

<hr />

<h2 id="-여러-경우를-한-번에-parameterizedtest">③ 여러 경우를 한 번에: @ParameterizedTest</h2>

<p>출고의 <code>endPicking</code>은 PICK과 EXCP일 때만 PACK으로 바뀌고, 나머지 6개 상태에서는 아무 일도 하지 않는다. 6개를 테스트로 하나씩 쓰면 지루하다.</p>

<pre><code class="language-java">@ParameterizedTest
@EnumSource(value = OutboundStepType.class, names = {"PICK", "EXCP"}, mode = EnumSource.Mode.EXCLUDE)
@DisplayName("PICK과 EXCP가 아니면 상태가 변경되지 않는다")
void endPickingFromOtherSteps(OutboundStepType step) {
    Outbound outbound = createOutboundWithStep(step);

    outbound.endPicking(2L);

    assertEquals(step, outbound.getOutboundStepType());
}
</code></pre>

<p>“<code>OutboundStepType</code> 중에서 PICK과 EXCP를 <strong>뺀</strong> 나머지 전부로 이 테스트를 돌려라”라는 뜻이다. WAIT, PACK, SHIP, DONE, CNCL, EXPA로 6번 실행된다.</p>

<pre><code class="language-ts">test.each(['WAIT', 'PACK', 'SHIP', 'DONE', 'CNCL', 'EXPA'])('%s면 상태가 안 바뀐다', (step) =&gt; { ... });
</code></pre>

<p><code>test.each</code>와 다른 점은 목록을 직접 쓰지 않는다는 것이다. 나중에 enum에 상태가 추가되면 <strong>자동으로 테스트 대상에 들어간다.</strong></p>

<p>테스트 이름도 다시 보게 됐다. “상태가 변경되지 않는다.” 6편에서 고민했던 “조용히 무시하는 동작”을 이 테스트가 명세로 못 박아 두고 있다. 테스트는 확인 도구이면서 “이 코드는 이렇게 동작해야 한다”고 적어 둔 문서이기도 하다.</p>

<hr />

<h2 id="-usecase-테스트-mockito로-가짜-끼우기">④ UseCase 테스트: Mockito로 가짜 끼우기</h2>

<p><code>DeleteFeatureFlag</code>는 생성자로 Port 4개를 주입받는다(3편 DI). 테스트에서는 이 4개를 모두 가짜로 바꾼다.</p>

<pre><code class="language-java">@ExtendWith(MockitoExtension.class)
class DeleteFeatureFlagTest {

    @InjectMocks                                    // 테스트 대상. 아래 가짜들을 생성자에 넣어서 만들어 준다
    private DeleteFeatureFlag deleteFeatureFlag;

    @Mock private UserApplicationService userService;
    @Mock private FindFeatureFlag findFeatureFlag;
    @Mock private FindUserFeatureFlagRelation findUserFeatureFlagRelation;
    @Mock private LoadFeatureFlagHistory loadFeatureFlagHistory;
</code></pre>

<p>3편에서 배운 DI와 같은 원리다. 서버에서는 Spring이 진짜 Repository를 넣어 주고, 테스트에서는 Mockito가 가짜를 넣어 준다. <code>DeleteFeatureFlag</code>는 생성자로 받기만 하니까 받은 게 진짜인지 가짜인지 모른다.</p>

<p>가짜에게는 대답을 미리 정해 준다.</p>

<pre><code class="language-java">@Test
@DisplayName("OFF 상태이고 연결된 사용자가 없으면 삭제되고 이력이 저장된다")
void deletesFeatureFlagAndSavesHistory() {
    // given
    FeatureFlag featureFlag = offFeatureFlag();
    given(findFeatureFlag.findFeatureFlag(10L)).willReturn(Optional.of(featureFlag));        // "10번 찾으면 이걸 줘"
    given(findUserFeatureFlagRelation.findByFeatureFlag(featureFlag)).willReturn(List.of()); // "연결된 사용자는 없어"

    // when
    deleteFeatureFlag.execute(new DeleteFeatureFlagCommand(1L, 10L));

    // then
    assertThat(featureFlag.getDeletedAt()).isNotNull();
    verify(loadFeatureFlagHistory).loadFeatureFlagHistory(any(FeatureFlagHistory.class));   // "이력 저장이 불렸나?"
}
</code></pre>

<table>
  <thead>
    <tr>
      <th>Mockito</th>
      <th>Vitest / MSW</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><code>@Mock</code></td>
      <td><code>vi.fn()</code>, <code>vi.mock()</code></td>
    </tr>
    <tr>
      <td><code>given(x.find(10L)).willReturn(flag)</code></td>
      <td><code>find.mockReturnValue(flag)</code>, MSW 핸들러</td>
    </tr>
    <tr>
      <td><code>verify(x).save(any())</code></td>
      <td><code>expect(save).toHaveBeenCalled()</code></td>
    </tr>
    <tr>
      <td><code>verifyNoInteractions(x)</code></td>
      <td><code>expect(x).not.toHaveBeenCalled()</code></td>
    </tr>
    <tr>
      <td><code>any(FeatureFlagHistory.class)</code></td>
      <td><code>expect.any(FeatureFlagHistory)</code></td>
    </tr>
  </tbody>
</table>

<h3 id="안-불렸다를-확인하는-게-더-중요할-때">“안 불렸다”를 확인하는 게 더 중요할 때</h3>

<pre><code class="language-java">@Test
@DisplayName("ON 상태면 사용자 조회 없이 예외를 던지고 삭제되지 않는다")
void throwsWhenActiveWithoutCheckingUsers() {
    // given
    FeatureFlag featureFlag = onFeatureFlag();
    given(findFeatureFlag.findFeatureFlag(10L)).willReturn(Optional.of(featureFlag));

    // when &amp; then
    assertThatThrownBy(() -&gt; deleteFeatureFlag.execute(new DeleteFeatureFlagCommand(1L, 10L)))
        .isInstanceOf(ActiveFeatureFlagException.class);

    assertThat(featureFlag.getDeletedAt()).isNull();
    verifyNoInteractions(findUserFeatureFlagRelation, loadFeatureFlagHistory);
}
</code></pre>

<p>처음엔 예외만 확인하면 충분하지 않나 싶었다. 그런데 누군가 순서를 바꿔서 <strong>이력을 먼저 저장하고 그다음에 검증</strong>하도록 고쳤다고 해 보자. 예외는 똑같이 나니까 예외만 보는 테스트는 통과한다. 하지만 실패한 삭제의 이력이 DB에 남는다. <code>verifyNoInteractions</code>가 이런 경우를 잡는다.</p>

<h3 id="usecase-테스트로는-확인할-수-없는-것">UseCase 테스트로는 확인할 수 없는 것</h3>

<p>여기엔 진짜 DB도 <code>@Transactional</code>도 없다. 그래서 객체의 <code>deletedAt</code>이 채워졌는지는 확인할 수 있지만, <strong>그 값이 DB에 UPDATE로 실제로 반영되는지</strong>는 알 수 없다(5편 변경 감지). 그건 다음 층에서 확인한다.</p>

<hr />

<h2 id="-통합-테스트-진짜로-끝까지">⑤ 통합 테스트: 진짜로 끝까지</h2>

<pre><code class="language-java">@Test
@DisplayName("피처플래그 전체 조회 시 저장된 목록을 반환한다")
void returnsAllSavedFeatureFlags() throws Exception {
    // given: 진짜 DB에 저장
    featureFlagJpaRepository.save(featureFlag("FF-TEST-001", "테스트 플래그 A"));
    featureFlagJpaRepository.save(featureFlag("FF-TEST-002", "테스트 플래그 B"));

    // when &amp; then: HTTP 요청처럼 호출하고 응답 JSON 확인
    mockMvc.perform(get("/api/v2/feature-flag"))
        .andExpect(status().isOk())
        .andExpect(jsonPath("$.data.details.length()").value(2));
}
</code></pre>

<p>Spring을 실제로 띄우고 DB에 데이터를 넣은 다음, Controller부터 Repository까지 전부 실제로 거쳐 간다. <code>jsonPath("$.data.details")</code>는 응답 JSON에서 값을 꺼내는 문법이다. 프론트에서 <code>response.data.data.details</code>를 읽는 것과 같다.</p>

<p>가장 확실하지만 가장 느리다. Spring을 띄우는 데만 몇 초가 걸린다. 그래서 핵심 흐름만 통합 테스트로 쓰고, 규칙 하나하나는 도메인 테스트로 확인한다. 테스트 구조가 피라미드 모양이 되는 이유다.</p>

<hr />

<h2 id="퀴즈-풀어-보기">퀴즈 풀어 보기</h2>

<p>이번 퀴즈는 직접 풀지 않고 바로 답을 봤다. 대신 답을 보면서 왜 그런지 하나씩 따라가 봤다.</p>

<h3 id="문제-1-규칙을-바꾸면-테스트는-어떻게-될까">문제 1: 규칙을 바꾸면 테스트는 어떻게 될까?</h3>

<p>6편에서 <code>endPicking</code>을 “이미 PACK 이후면 무시하고, 그 밖의 잘못된 상태면 예외를 던진다”로 바꾸자는 이야기가 있었다. 그렇게 바꾸면 ③의 테스트는 어떻게 될까?</p>

<p>6개 상태가 둘로 갈린다.</p>

<ul>
  <li><strong>PACK, SHIP, DONE</strong>: 계속 무시된다. 테스트를 통과한다.</li>
  <li><strong>WAIT, CNCL, EXPA</strong>: 이제 예외가 난다. 테스트가 <strong>실패한다.</strong></li>
</ul>

<p>처음엔 테스트가 깨지면 나쁜 일이라고 생각했다. 하지만 이 테스트에는 “이 상태들에서는 조용히 무시한다”는 기존 명세가 담겨 있다. 동작을 일부러 바꿨다면 명세도 함께 바꾸는 게 맞고, 테스트가 그걸 알려 준 것이다. 실수로 바꾼 거라면 배포 전에 버그를 잡아 준 것이다. 어느 쪽이든 아무 일 없이 통과하는 것보다 낫다.</p>

<p>규칙을 바꾼 뒤에는 테스트도 두 개로 나눈다.</p>

<pre><code class="language-java">@EnumSource(names = {"PACK", "SHIP", "DONE"})   // 무시되는지
@EnumSource(names = {"WAIT", "CNCL", "EXPA"})   // 예외가 나는지
</code></pre>

<h3 id="문제-2-택배-출하-검증-테스트-빈칸-채우기">문제 2: 택배 출하 검증 테스트 빈칸 채우기</h3>

<pre><code class="language-java">@Test
@DisplayName("택배 출고가 PACK 상태여도 송장이 없으면 NotIssuedTrackingNumberException을 던진다")
void throwsWhenNoTrackingNumber() {
    // given
    OutboundStatusChangeTarget outbound = new OutboundStatusChangeTarget(
        1L, OutboundStepType.PACK, TransportType.CARRIER, List.of()
    );
    CarrierChangeOutboundStatusValidator validator = new CarrierChangeOutboundStatusValidator();

    // when &amp; then
    assertThatThrownBy(() -&gt; validator.validate(outbound))
        .isInstanceOf(NotIssuedTrackingNumberException.class);
}
</code></pre>

<p>빈칸에 들어갈 답은 <code>PACK</code>, <code>List.of()</code>, <code>NotIssuedTrackingNumberException</code>이다. 포장까지 끝난 택배 출고인데 송장 목록이 비어 있으니 “송장 미발번” 예외가 나야 한다. 테스트 이름이 곧 시나리오가 되고, given에는 그 시나리오를 그대로 옮겨 적으면 된다는 게 보였다.</p>

<h3 id="문제-3-transactional을-실수로-지우면">문제 3: @Transactional을 실수로 지우면?</h3>

<p>UseCase 위의 <code>@Transactional</code>을 누가 실수로 지웠다면, UseCase 테스트는 통과할까?</p>

<p><strong>통과한다.</strong> <code>@Transactional</code>은 Spring이 붙여 주는 기능인데, Mockito 테스트에는 Spring이 없다. 그러니 어노테이션이 있든 없든 테스트 결과는 같다. 이 테스트는 “메서드가 불렸나”, “필드가 바뀌었나”만 확인한다.</p>

<p>실제 서버에서는 트랜잭션이 없으니 변경 감지가 동작하지 않는다. <code>deletedAt</code>을 바꿔도 UPDATE가 나가지 않아서 삭제가 저장되지 않는다.</p>

<p>이 실수는 Spring과 DB를 실제로 띄우는 <strong>통합 테스트</strong>만 잡을 수 있다. 삭제 API를 호출한 다음 DB에서 다시 조회해서 <code>deletedAt</code>을 확인하는 식이다. 아래층 테스트가 아무리 많아도 위층 테스트를 남겨 둬야 하는 이유를 이 문제로 납득했다.</p>

<hr />

<h2 id="정리">정리</h2>

<table>
  <thead>
    <tr>
      <th>개념</th>
      <th>한 줄 요약</th>
      <th>프론트 비유</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>given / when / then</td>
      <td>준비, 실행, 확인을 나눠 쓴다</td>
      <td>Arrange / Act / Assert</td>
    </tr>
    <tr>
      <td><code>assertThat</code>, <code>assertThatThrownBy</code></td>
      <td>값과 예외를 확인한다</td>
      <td><code>expect().toBe()</code>, <code>toThrow()</code></td>
    </tr>
    <tr>
      <td><code>@ParameterizedTest</code> + <code>@EnumSource</code></td>
      <td>enum 전체로 반복한다</td>
      <td><code>test.each</code></td>
    </tr>
    <tr>
      <td><code>@Mock</code>, <code>@InjectMocks</code></td>
      <td>Port 자리에 가짜를 주입한다</td>
      <td><code>vi.fn()</code>, MSW</td>
    </tr>
    <tr>
      <td><code>verify</code>, <code>verifyNoInteractions</code></td>
      <td>불렸는지, 안 불렸는지 확인한다</td>
      <td><code>toHaveBeenCalled</code></td>
    </tr>
    <tr>
      <td>통합 테스트</td>
      <td>MockMvc와 진짜 DB로 끝까지 확인한다</td>
      <td>Playwright</td>
    </tr>
  </tbody>
</table>

<p>테스트 문법 자체는 Jest와 거의 같아서 금방 읽혔다. 오히려 새로 알게 된 건 지금까지 배운 설계가 테스트를 쉽게 만들어 준다는 점이었다. 규칙을 Entity에 둬서 도메인 테스트가 순수 Java로 끝나고, Port로 DB를 감춰 둬서 UseCase 테스트에 가짜를 끼울 수 있다. 반대로 말하면 테스트 쓰기가 어려운 코드는 설계부터 의심해 볼 만하다.</p>

<p>다음 글에서는 신규 코드와 다르게 SQL을 직접 쓰는 <a href="/OHaEuN/32"><strong>레거시 MyBatis</strong></a>를 공부할 예정이다.</p>]]></content><author><name>OHaEuN</name></author><category term="Back-end" /><category term="백엔드 입문" /><category term="테스트" /><category term="JUnit" /><category term="Mockito" /><category term="통합 테스트" /><summary type="html"><![CDATA[Jest에 익숙한 프론트 개발자가 JUnit과 Mockito를 따라가며 정리한 백엔드 테스트. 도메인, UseCase, 통합 테스트의 세 층과 각각이 잡는 문제, 그리고 설계가 테스트를 쉽게 만드는 이유.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://ohaeun.github.io/OHaEuN/assets/posts/30/thumbnail.jpg" /><media:content medium="image" url="https://ohaeun.github.io/OHaEuN/assets/posts/30/thumbnail.jpg" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">[백엔드 입문 #7] Spring 예외가 프론트 에러 응답이 되는 과정</title><link href="https://ohaeun.github.io/OHaEuN/29" rel="alternate" type="text/html" title="[백엔드 입문 #7] Spring 예외가 프론트 에러 응답이 되는 과정" /><published>2026-11-04T13:25:00+09:00</published><updated>2026-11-04T13:25:00+09:00</updated><id>https://ohaeun.github.io/OHaEuN/29</id><content type="html" xml:base="https://ohaeun.github.io/OHaEuN/29"><![CDATA[<p>프론트에서 매일 쓰는 코드가 있다.</p>

<pre><code class="language-ts">try {
  await api.post('/outbound/ship', { ids });
} catch (e) {
  toast.error(e.response.data.message);   // "송장 번호가 발번되어 있지 않습니다."
}
</code></pre>

<p>이 <code>message</code>가 서버 어디에서 만들어지는지는 생각해 본 적이 없었다. <a href="/OHaEuN/28">지난 글</a>에서 출고 도메인 모델을 보면서 <code>throw new ...Exception</code>을 잔뜩 봤는데, 이번에는 그 예외가 어떻게 이 JSON이 되는지 따라가 봤다.</p>

<blockquote>
  <p>글에 나오는 코드는 이해를 돕기 위해 일부 단순화했다.</p>
</blockquote>

<hr />

<h2 id="-예외는-위로-올라간다">① 예외는 위로 올라간다</h2>

<p>택배 출고를 송장 없이 출하하려고 하면 이런 순서로 흘러간다.</p>

<pre><code>Controller.ship()
  └─ UseCase.execute()                    @Transactional
       └─ CarrierValidator.validate()
            └─ throw new NotIssuedTrackingNumberException(id)   💥
</code></pre>

<p><code>throw</code>가 일어나면 그 아래 코드는 실행되지 않고, 예외가 <strong>자기를 부른 쪽으로 계속 올라간다.</strong> 누군가 <code>catch</code>할 때까지.</p>

<ol>
  <li>Validator에서 터진다.</li>
  <li>UseCase를 지나면서 <code>@Transactional</code>이 예외를 보고 <strong>롤백</strong>한다. (<a href="/OHaEuN/27">5편</a>에서 본 내용)</li>
  <li>Controller에도 <code>try/catch</code>가 없으니 그냥 통과한다.</li>
  <li>결국 Spring까지 올라온다.</li>
</ol>

<p>그런데 Controller를 아무리 찾아봐도 <code>try/catch</code>가 없었다. 그럼 누가 잡는 걸까?</p>

<hr />

<h2 id="-전역-예외-처리기-restcontrolleradvice">② 전역 예외 처리기: @RestControllerAdvice</h2>

<pre><code class="language-java">@RestControllerAdvice                       // 모든 Controller에서 올라온 예외를 여기서 잡는다
public class GlobalControllerException {

    @ExceptionHandler(AppException.class)  // AppException과 그 자식들이 올라오면 실행
    public ResponseEntity&lt;AppResponse&lt;Void&gt;&gt; handleAppException(AppException e) {
        if (e.isClientError()) {
            log.warn(e.getLogMessage());
        } else {
            log.error(e.getLogMessage(), e);
        }
        return ResponseEntity
            .status(e.getStatusCode())                                   // HTTP 상태 코드
            .body(AppResponse.fail(e.getMessage(), e.getErrorCode()));  // JSON body
    }
}
</code></pre>

<p>Controller 수백 개가 각자 <code>try/catch</code>를 쓰는 대신, <strong>이 한 곳에서 모든 예외를 응답으로 바꾼다.</strong></p>

<p>프론트에도 같은 생각으로 만든 게 있다.</p>

<ul>
  <li><strong>axios interceptor</strong>: 모든 응답 에러를 한 곳에서 처리한다.</li>
  <li><strong>React ErrorBoundary</strong>: 하위 컴포넌트 어디서 터지든 위에서 잡아 에러 화면을 보여 준다.</li>
</ul>

<p>그래서 프론트는 이런 응답을 받는다.</p>

<pre><code>HTTP/1.1 422 Unprocessable Entity

{
  "data": null,
  "message": "송장 번호가 발번되어 있지 않습니다.",
  "errorCode": "outbound/not-issued-tracking-number",
  "validations": null
}
</code></pre>

<p><a href="/OHaEuN/22">1편</a>부터 계속 본 <code>AppResponse</code>가 성공일 때는 <code>success(data)</code>, 실패일 때는 <code>fail(message, errorCode)</code>로 같은 모양을 유지한다. 프론트는 항상 같은 구조로 파싱하면 된다.</p>

<hr />

<h2 id="-예외-하나에-메시지가-세-개인-이유">③ 예외 하나에 메시지가 세 개인 이유</h2>

<pre><code class="language-java">public class NotIssuedTrackingNumberException extends AppRuleException {

    private static final String MESSAGE     = "송장 번호가 발번되어 있지 않습니다.";
    private static final String ERROR_CODE  = "outbound/not-issued-tracking-number";
    private static final String LOG_MESSAGE = "[송장 미발번] %d 주문 상태 변경 실패";

    public NotIssuedTrackingNumberException(Long id) {
        super(MESSAGE, ERROR_CODE, LOG_MESSAGE.formatted(id));
    }
}
</code></pre>

<table>
  <thead>
    <tr>
      <th>필드</th>
      <th>누가 보나</th>
      <th>용도</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><code>message</code></td>
      <td>창고 작업자 (토스트)</td>
      <td>사람이 읽는 안내 문구</td>
    </tr>
    <tr>
      <td><code>errorCode</code></td>
      <td>프론트 코드</td>
      <td><code>if</code>로 분기하는 기계용 값</td>
    </tr>
    <tr>
      <td><code>logMessage</code></td>
      <td>백엔드 개발자 (서버 로그)</td>
      <td>어떤 출고(id)에서 났는지 추적</td>
    </tr>
  </tbody>
</table>

<p>로그에는 “출고 12345번에서 실패”처럼 id가 있어야 추적할 수 있다. 하지만 그걸 사용자 화면에 보여 줄 필요는 없다. 내부 정보는 로그에만 남기고 화면에는 안내 문구만 보낸다.</p>

<p><code>errorCode</code>가 따로 있는 이유는 퀴즈에서 제대로 알게 됐다. 아래에서 다시 정리한다.</p>

<hr />

<h2 id="-예외-종류가-곧-http-상태-코드">④ 예외 종류가 곧 HTTP 상태 코드</h2>

<p>이 프로젝트의 예외는 상속 구조로 상태 코드가 정해져 있었다.</p>

<pre><code>RuntimeException
└─ AppException (기본 500)
   ├─ AppValidationV2Exception    400  요청 형식이 틀림 (필수값 누락 등)
   ├─ AppUnAuthorizationException 401  로그인 안 함
   ├─ AppForbiddenException       403  로그인은 했는데 권한 없음
   ├─ AppNotFoundException        404  찾는 게 없음
   ├─ AppConflictException        409  다른 데이터와 충돌 (중복 등)
   ├─ AppRuleException            422  요청은 멀쩡한데 비즈니스 규칙 위반
   └─ AppServerException          500  서버 잘못
</code></pre>

<p>예외 클래스를 만들 때 <strong>어떤 부모를 <code>extends</code> 할지 고르는 게 곧 상태 코드를 고르는 것</strong>이다. <code>NotIssuedTrackingNumberException</code>은 <code>AppRuleException</code>을 상속했으니 422가 된다. 요청 형식은 맞는데 “송장 없이 출하 불가”라는 규칙에 걸렸기 때문이다.</p>

<p>처음에 헷갈렸던 건 400과 422의 차이였다.</p>

<ul>
  <li><strong>400</strong>: <code>{ "ids": "abc" }</code>처럼 숫자 자리에 문자를 보냄 → 요청 자체가 틀림</li>
  <li><strong>422</strong>: 요청은 완벽한데, 이 출고는 지금 출하할 수 없는 상태 → 규칙 위반</li>
</ul>

<hr />

<h2 id="-warn과-error를-나누는-이유">⑤ warn과 error를 나누는 이유</h2>

<pre><code class="language-java">if (e.isClientError()) {          // 4xx
    log.warn(e.getLogMessage());
} else {                          // 5xx
    log.error(e.getLogMessage(), e);
}
</code></pre>

<ul>
  <li><strong>4xx</strong>: 작업자가 송장 없이 출하를 눌렀다. 시스템은 정상이고, 막아야 할 걸 잘 막았다. 하루에 수백 번 일어나도 괜찮다. → <code>warn</code></li>
  <li><strong>5xx</strong>: 서버 코드가 터졌다. 개발자가 고쳐야 한다. → <code>error</code>. 보통 Sentry나 Datadog 알림이 이걸 보고 울린다.</li>
</ul>

<p>4xx까지 전부 <code>error</code>로 찍으면 새벽에 “작업자가 송장 없이 출하 누름” 알림이 수백 개 온다. 그러다 진짜 장애 알림이 그 사이에 묻힌다.</p>

<hr />

<h2 id="-실제-코드에서-보인-것들">⑥ 실제 코드에서 보인 것들</h2>

<p><strong>404여야 할 것 같은데 422인 예외</strong></p>

<pre><code class="language-java">public class NotFoundFeatureFlagException extends AppRuleException { ... }   // 422
</code></pre>

<p>이름은 NotFound인데 <code>AppRuleException</code>을 상속해서 404가 아니라 422가 나간다. 상태 코드별 예외가 나중에 생겨서 일관되지 않은 부분이 남아 있었다. 프론트에서 <code>status === 404</code>로 분기했다면 이 API에서는 걸리지 않는다.</p>

<p><strong>에러인데 200 OK로 오는 응답</strong></p>

<p>같은 처리기 아래쪽에 레거시용 코드가 있었다.</p>

<pre><code class="language-java">return ResponseEntity.ok(new LegacyValidationResponse(response));   // 에러인데 200
</code></pre>

<p>레거시 API는 에러도 HTTP 200으로 보내고, body 안에 에러 코드를 넣었다. 프론트에서 “응답은 200인데 왜 실패지?”를 겪었던 이유가 이거였다. 기존 프론트 코드가 이 형식에 맞춰져 있어서 하위 호환을 위해 남겨 둔 것이다.</p>

<p><strong>아무도 예상하지 못한 예외</strong></p>

<p><code>NullPointerException</code>처럼 <code>AppException</code>이 아닌 예외는 위 처리기에 걸리지 않는다. Spring 기본 처리로 넘어가서 500과 Spring 기본 에러 JSON이 나간다. <code>AppResponse</code> 모양이 아니라서 프론트에서 <code>e.response.data.message</code>가 <code>undefined</code>가 될 수 있다.</p>

<hr />

<h2 id="퀴즈-풀어-보기">퀴즈 풀어 보기</h2>

<h3 id="문제-1-없는-출고를-조회하면">문제 1: 없는 출고를 조회하면?</h3>

<p>출고 조회 API에 없는 id(999999)로 요청이 왔다. 새 예외 <code>NotFoundOutboundException</code>은 어떤 클래스를 상속해야 하고, 프론트는 어떤 상태 코드와 JSON을 받으며, 로그는 어느 레벨로 찍힐까?</p>

<p><code>AppNotFoundException</code>을 상속한다고만 답하고 나머지는 빠뜨렸다. 부모를 정하면 나머지는 저절로 따라온다는 걸 연결하지 못한 것이다.</p>

<pre><code class="language-java">public class NotFoundOutboundException extends AppNotFoundException { ... }
</code></pre>

<pre><code>HTTP/1.1 404 Not Found

{
  "data": null,
  "message": "출고 정보를 찾을 수 없습니다.",
  "errorCode": "outbound/not-found",
  "validations": null
}
</code></pre>

<p>404는 4xx라서 <code>isClientError()</code>가 true이고, 로그는 <code>warn</code>으로 찍힌다. 없는 id로 조회한 건 서버 버그가 아니니 알림을 울릴 일도 아니다. <strong>부모 클래스 하나를 고르면 상태 코드, 응답, 로그 레벨이 한꺼번에 정해진다.</strong></p>

<h3 id="문제-2-db-에러를-그대로-던지면">문제 2: DB 에러를 그대로 던지면?</h3>

<pre><code class="language-java">catch (DataIntegrityViolationException e) {
    throw new AppRuleException(
        e.getMessage(),   // "Duplicate entry 'NEW_PICKING' for key 'uk_feature_flag_code'"
        "feature-flag/duplicate",
        e.getMessage()
    );
}
</code></pre>

<p>errorCode가 항상 똑같은 게 문제라고 답했는데, 짚은 곳이 틀렸다. “중복”이라는 한 가지 상황이니 errorCode가 하나인 건 오히려 맞다. 프론트는 이 값으로 분기하면 된다.</p>

<p>진짜 문제는 <strong><code>message</code> 자리에 <code>e.getMessage()</code>를 넣은 것</strong>이었다. <code>message</code>는 토스트로 뜨는 문구라서, 작업자 화면에 이게 그대로 뜬다.</p>

<pre><code>Duplicate entry 'NEW_PICKING' for key 'uk_feature_flag_code'
</code></pre>

<ul>
  <li><strong>작업자가 읽을 수 없다.</strong> 영어로 된 DB 에러라 무엇을 하라는 건지 알 수 없다.</li>
  <li><strong>내부 정보가 새어 나간다.</strong> 제약 조건 이름, DB 종류 같은 서버 내부 구조가 브라우저까지 간다. 공격하는 쪽에는 좋은 힌트가 된다.</li>
</ul>

<pre><code class="language-java">catch (DataIntegrityViolationException e) {
    throw new AppConflictException(                       // 중복은 409가 더 맞다
        "이미 등록된 기능 플래그 코드입니다.",                  // 사용자용 문구
        "feature-flag/duplicate",                          // 그대로
        "기능 플래그 코드 중복: " + e.getMessage()             // 원문은 로그에만
    );
}
</code></pre>

<p><strong>DB나 라이브러리의 원문 에러는 로그에만 남기고, 화면에는 사람이 쓴 문구만 보낸다.</strong></p>

<h3 id="문제-3-송장-발행-모달을-자동으로-띄우려면">문제 3: 송장 발행 모달을 자동으로 띄우려면?</h3>

<p>“송장이 없다는 에러가 나면 송장 발행 모달을 자동으로 띄워 주세요”라는 요구가 왔다. <code>message</code>와 <code>errorCode</code> 중 무엇으로 분기해야 할까?</p>

<p>처음엔 질문 자체가 무슨 뜻인지 몰랐다. 프론트에서 “이게 송장 없음 에러인지”를 판단해야 하는데, 그 판단 기준을 무엇으로 하느냐는 질문이었다.</p>

<pre><code class="language-ts">// A: 문구로 판단
if (e.response.data.message === '송장 번호가 발번되어 있지 않습니다.') openModal();

// B: 코드로 판단
if (e.response.data.errorCode === 'outbound/not-issued-tracking-number') openModal();
</code></pre>

<p>답은 B다. 기획자가 문구를 “송장이 아직 없어요. 먼저 발행해 주세요”로 바꾸면 백엔드는 <code>MESSAGE</code> 상수만 고친다. 그러면 A는 문자열이 안 맞아서 모달이 <strong>조용히 안 뜬다.</strong> 에러도 나지 않아서 한참 뒤에야 알게 된다.</p>

<p><code>errorCode</code>는 문구가 바뀌어도 그대로인 <strong>프론트와 백엔드 사이의 약속</strong>이다. 프론트에서 번역된 한국어 문장이 아니라 i18n 키(<code>t('outbound.notIssued')</code>)로 분기하는 것과 같은 이유다.</p>

<table>
  <thead>
    <tr>
      <th> </th>
      <th><code>message</code></th>
      <th><code>errorCode</code></th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>보는 쪽</td>
      <td>사람 (토스트)</td>
      <td>코드 (<code>if</code>문)</td>
    </tr>
    <tr>
      <td>바뀌어도 되나</td>
      <td>언제든 바뀔 수 있음</td>
      <td>바뀌면 안 됨</td>
    </tr>
    <tr>
      <td>프론트에서</td>
      <td>화면에 보여 주기만</td>
      <td>분기할 때 사용</td>
    </tr>
  </tbody>
</table>

<hr />

<h2 id="정리">정리</h2>

<table>
  <thead>
    <tr>
      <th>개념</th>
      <th>한 줄 요약</th>
      <th>프론트 비유</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>예외 전파</td>
      <td>Entity → UseCase(롤백) → Controller → 처리기</td>
      <td>하위 컴포넌트 에러가 위로</td>
    </tr>
    <tr>
      <td>전역 예외 처리기</td>
      <td><code>@RestControllerAdvice</code> 한 곳에서 응답으로 변환</td>
      <td>axios interceptor, ErrorBoundary</td>
    </tr>
    <tr>
      <td>message / errorCode / logMessage</td>
      <td>사용자용 / 코드용 / 개발자용</td>
      <td>토스트 문구 / i18n 키 / console</td>
    </tr>
    <tr>
      <td>부모 예외 선택</td>
      <td>상속한 부모가 상태 코드를 정함</td>
      <td><code>error.response.status</code></td>
    </tr>
    <tr>
      <td>warn / error</td>
      <td>4xx는 warn, 5xx는 error(알림)</td>
      <td>—</td>
    </tr>
  </tbody>
</table>

<p>프론트에서 늘 <code>e.response.data.message</code>를 꺼내 쓰기만 했는데, 그 한 줄 뒤에 “누가 읽을 문구인가”, “바뀌어도 되는 값인가”를 나눠 둔 설계가 있었다. 앞으로 에러 분기 코드를 짤 때는 문구가 아니라 errorCode를 먼저 찾게 될 것 같다.</p>

<p>다음 글에서는 이런 규칙들이 정말 지켜지는지 확인하는 <a href="/OHaEuN/30"><strong>테스트(JUnit, Mockito)</strong></a>를 공부할 예정이다.</p>]]></content><author><name>OHaEuN</name></author><category term="Back-end" /><category term="백엔드 입문" /><category term="예외 처리" /><category term="RestControllerAdvice" /><category term="HTTP 상태 코드" /><category term="Spring" /><summary type="html"><![CDATA[프론트에서 매일 꺼내 쓰던 e.response.data.message가 서버 어디에서 만들어지는지 따라갔다. 예외 전파, 전역 예외 처리기, message/errorCode/logMessage의 역할, 예외 종류와 HTTP 상태 코드, warn과 error의 구분까지.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://ohaeun.github.io/OHaEuN/assets/posts/29/thumbnail.jpg" /><media:content medium="image" url="https://ohaeun.github.io/OHaEuN/assets/posts/29/thumbnail.jpg" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">[백엔드 입문 #6] 출고 상태 규칙을 도메인 모델에 두는 이유와 멱등성</title><link href="https://ohaeun.github.io/OHaEuN/28" rel="alternate" type="text/html" title="[백엔드 입문 #6] 출고 상태 규칙을 도메인 모델에 두는 이유와 멱등성" /><published>2026-10-30T10:40:00+09:00</published><updated>2026-10-30T10:40:00+09:00</updated><id>https://ohaeun.github.io/OHaEuN/28</id><content type="html" xml:base="https://ohaeun.github.io/OHaEuN/28"><![CDATA[<p><a href="/OHaEuN/27">지난 글</a>에서 트랜잭션을 정리하면서 “다음에는 출고 도메인 모델을 열어 보겠다”고 했다. 처음에는 출고 상태가 몇 개인지, 어떤 순서로 바뀌는지를 외우는 식으로 공부했다. 그러다 문득 이런 생각이 들었다.</p>

<p><strong>“이거 그냥 우리 회사 구현 내용 아닌가? 백엔드 공부랑 무슨 상관이지?”</strong></p>

<p>다시 보니 출고는 예시일 뿐이었다. 진짜 주제는 백엔드에서 매일 하는 고민 하나였다. <strong>“이 상태에서는 이걸 하면 안 된다” 같은 규칙을 코드 어디에 둘까?</strong> 쇼핑몰이면 “배송 시작된 주문은 취소 불가”, 은행이면 “잔액보다 많이 출금 불가” 같은 규칙이다. 이번 글은 WMS 출고를 따라가면서 이 질문을 정리한다.</p>

<blockquote>
  <p>글에 나오는 코드는 이해를 돕기 위해 일부 단순화했다.</p>
</blockquote>

<hr />

<h2 id="-출고-하나가-창고를-지나가는-길">① 출고 하나가 창고를 지나가는 길</h2>

<p>쇼핑몰에서 주문이 들어오면 WMS에 출고 한 건이 생기고, 이렇게 흘러간다.</p>

<pre><code>WAIT ──→ PICK ──→ PACK ──→ SHIP ──→ DONE
대기      피킹      패킹      출하      완료
          (선반에서  (박스에   (트럭/택배
           꺼내기)   담기)     에 실음)
</code></pre>

<p>중간에 빠지는 길도 있다. 고객이 주문을 취소하면 <strong>CNCL(취소)</strong>, 재고가 없거나 문제가 생기면 <strong>EXCP(예외)</strong> 로 간다.</p>

<pre><code class="language-java">@Enumerated(EnumType.STRING)
@Column(name = "outbound_step_cd")
private OutboundStepType outboundStepType;   // WAIT, PICK, PACK, SHIP, DONE, CNCL, EXPA, EXCP
</code></pre>

<p>이 흐름에는 지켜야 할 규칙이 있다.</p>

<ul>
  <li>피킹을 안 했는데 패킹으로 넘어가면 안 된다. 빈 박스를 싸게 된다.</li>
  <li>이미 트럭에 실린(SHIP) 출고는 취소할 수 없다. 물건이 이미 창고를 떠났다.</li>
  <li>취소된 출고를 피킹하면 안 된다. 작업자가 헛걸음한다.</li>
</ul>

<p>프론트에서 상태가 꼬이면 화면이 잠깐 이상해지는 정도다. 그런데 여기서 규칙이 깨지면 <strong>실제 창고에서 물건이 잘못 움직인다.</strong> 그래서 규칙을 어디에 두느냐가 중요하다.</p>

<hr />

<h2 id="-방식-a-service가-규칙을-들고-있기">② 방식 A: Service가 규칙을 들고 있기</h2>

<p>레거시 코드에서 쇼핑몰 주문이 취소됐을 때 출고를 취소하는 부분이다.</p>

<pre><code class="language-java">if (ShopOrderStatsCd.CNL.name().equals(dto.getShopOrderStatsCd())) {
    outboundVO.setCancelStepCd(dto.getOutboundStepCd());   // 어느 단계에서 취소됐는지
    outboundVO.setOutboundStepCd(STEP_CD_CNCL);            // 단계 = 취소
    outboundVO.setStatsCd(OutboundStats.CNCL);             // 상황 = 취소
    outboundVO.setCancelDt(param.getBaseDt());             // 취소 시각
}
</code></pre>

<p><code>OutboundVO</code>는 setter만 있는 <strong>데이터 상자</strong>다. “출고 취소란 필드 4개를 이렇게 바꾸는 것”이라는 규칙은 이 Service만 알고 있다.</p>

<p>그런데 출고를 취소하는 길은 하나가 아니다.</p>

<ul>
  <li>쇼핑몰 주문 동기화로 들어온 취소</li>
  <li>관리자가 화면에서 직접 하는 취소</li>
  <li>판매자가 API로 요청한 취소</li>
  <li>재고 부족으로 처리할 수 없어서 하는 취소</li>
</ul>

<p>길이 4개면 이 4줄도 4번 복사된다. 누군가 새 취소 기능을 만들면서 <code>setCancelDt</code>를 빠뜨리면? 에러는 안 난다. DB에 <strong>취소됐는데 취소 시각이 없는 출고</strong>가 조용히 쌓이고, 몇 달 뒤 “취소 통계가 안 맞아요”라는 문의가 와서야 알게 된다.</p>

<p>4곳 중 한 곳에서 <strong>“이미 SHIP이면 취소 불가”</strong> 검사를 빠뜨리면 더 심각하다. 트럭에 실려 나간 물건이 시스템에서는 취소로 바뀌고, 재고와 정산이 다 틀어진다.</p>

<p>프론트로 치면 컴포넌트마다 <code>setOrder({ ...order, status: 'CANCEL' })</code>를 직접 쓰고 있는 상황이다.</p>

<hr />

<h2 id="-방식-b-출고가-자기-규칙을-지키기">③ 방식 B: 출고가 자기 규칙을 지키기</h2>

<p>새 코드의 <code>Outbound</code> 엔티티에는 단계를 바꾸는 setter가 없다. 대신 <strong>무엇을 하는지를 이름으로 가진 메서드</strong>가 있다.</p>

<pre><code class="language-java">public void startPickingForRobot(Long userId) {
    if (this.outboundStepType.equals(OutboundStepType.WAIT)) {   // 대기 중일 때만
        this.outboundStepType = OutboundStepType.PICK;
        this.pickingDt = LocalDateTime.now();                    // 피킹 시작 시각도 같이
        this.updatedId = userId;
    }
}

public void endPicking(Long userId) {
    if (this.outboundStepType.equals(OutboundStepType.PICK)
        || this.outboundStepType.equals(OutboundStepType.EXCP)) { // 피킹 중일 때만
        this.outboundStepType = OutboundStepType.PACK;
        this.updatedId = userId;
    }
}
</code></pre>

<p>로봇이 피킹을 시작하든 작업자가 PDA로 스캔하든, 부르는 쪽은 메서드 한 줄만 쓴다.</p>

<ul>
  <li>“WAIT일 때만 PICK으로 간다”는 규칙을 건너뛸 수 없다.</li>
  <li>“PICK으로 갈 때 시각도 기록한다”는 걸 빠뜨릴 수 없다.</li>
  <li>규칙이 바뀌면 이 메서드 하나만 고치면 된다.</li>
</ul>

<p>②의 취소도 이 방식으로 쓰면 이렇게 된다.</p>

<pre><code class="language-java">public void cancel(Long userId) {
    if (this.outboundStepType == SHIP || this.outboundStepType == DONE) {
        throw new AlreadyShippedOutboundException(this.id);   // 이미 나간 건 취소 불가
    }
    this.cancelStepType = this.outboundStepType;
    this.outboundStepType = CNCL;
    this.statsCd = OutboundStatsType.CANCEL;
    this.cancelDt = LocalDateTime.now();
    this.updatedId = userId;
}
</code></pre>

<p>취소 길이 4개여도 모두 <code>outbound.cancel(userId)</code>를 부른다. 규칙은 한 곳에만 있다.</p>

<p>프론트로 치면 <strong>리듀서</strong>다. 컴포넌트는 <code>dispatch({ type: 'CANCEL' })</code>만 하고, 무엇을 어떻게 바꿀지는 리듀서가 정한다.</p>

<table>
  <thead>
    <tr>
      <th> </th>
      <th>방식 A</th>
      <th>방식 B</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>이름</td>
      <td>빈약한 도메인 모델 (Anemic)</td>
      <td>풍부한 도메인 모델 (Rich)</td>
    </tr>
    <tr>
      <td>출고 객체</td>
      <td>setter만 있는 데이터 상자</td>
      <td>데이터 + 상태 규칙</td>
    </tr>
    <tr>
      <td>규칙 위치</td>
      <td>취소하는 Service마다 복사됨</td>
      <td><code>Outbound.cancel()</code> 한 곳</td>
    </tr>
    <tr>
      <td>위험</td>
      <td>한 곳만 빠뜨려도 조용히 깨짐</td>
      <td>규칙을 건너뛸 수 없음</td>
    </tr>
  </tbody>
</table>

<p>우리 프로젝트가 레거시(MyBatis)에서 새 구조(JPA)로 옮기면서 바꾸려는 게 바로 이거였다. 팀 문서에 있던 <strong>“도메인 로직은 반드시 도메인 모델 안에”</strong> 라는 한 줄이 이제야 이해됐다.</p>

<p>setter를 막아서 규칙이 있는 메서드로만 상태를 바꾸게 하는 것을 <strong>캡슐화</strong>라고 한다. 다만 실제 코드에는 <code>@Builder</code>가 열려 있어서, 이걸로 객체를 만들면 메서드를 거치지 않고 아무 단계나 넣을 수 있었다. 레거시를 옮겨 오는 과도기라 교과서와 다른 부분도 있다.</p>

<hr />

<h2 id="-상태를-묻는-것도-출고에게">④ 상태를 묻는 것도 출고에게</h2>

<p>규칙은 상태를 <strong>바꿀 때만</strong> 있는 게 아니다. <strong>물어볼 때도</strong> 있다.</p>

<pre><code class="language-java">public boolean isPackingInProgress() {
    return OutboundStepType.PACK.equals(outboundStepType)
        &amp;&amp; !OutboundStatsType.CANCEL.equals(statsCd)
        &amp;&amp; !OutboundStatsType.CANCEL_WAIT.equals(statsCd);
}
</code></pre>

<p><code>statsCd</code>는 단계와 별개인 <strong>상황</strong>이다. 고객이 주문을 취소했는데 창고에서는 이미 박스를 싸고 있으면, 단계는 PACK인데 상황은 <code>CANCEL_WAIT</code>(취소 대기)가 된다.</p>

<p>그래서 “패킹 진행 중”이란 <strong>PACK이면서 취소(대기)가 아닌 것</strong>이다. 이 조건을 Service마다 직접 쓰면 누군가는 <code>CANCEL_WAIT</code>를 빠뜨린다. 그러면 취소될 박스에 택배 라벨이 붙는다.</p>

<pre><code class="language-java">// 이렇게 쓰면 CANCEL_WAIT를 빠뜨린다
if (outbound.getOutboundStepType() == PACK &amp;&amp; outbound.getStatsCd() != CANCEL) { ... }

// 이렇게 쓴다
if (outbound.isPackingInProgress()) { ... }
</code></pre>

<p>프론트의 <strong>selector</strong>(<code>selectIsPackingInProgress(state)</code>)와 같은 역할이다.</p>

<hr />

<h2 id="-같은-스캔이-두-번-오면-멱등성">⑤ 같은 스캔이 두 번 오면: 멱등성</h2>

<p>③의 <code>endPicking</code>을 다시 보면 이상한 점이 있다. 조건이 안 맞으면 <strong>예외 없이 그냥 아무것도 안 한다.</strong> 피처 플래그는 규칙에 어긋나면 예외를 던졌는데, 이건 왜 무시할까?</p>

<p>창고 현장을 떠올리면 이유가 보인다.</p>

<p>작업자가 PDA로 피킹 완료 바코드를 찍었다. 서버는 PICK → PACK으로 바꾸고 응답을 보냈는데, 창고 구석이라 와이파이가 끊겨서 응답이 PDA에 도착하지 못했다. 작업자는 반응이 없으니 <strong>한 번 더 찍는다.</strong></p>

<pre><code>1번째 스캔: PICK → PACK ✅  (응답 유실)
2번째 스캔: 이미 PACK인데 또 endPicking
</code></pre>

<ul>
  <li><strong>예외를 던지면</strong>: PDA에 빨간 에러가 뜬다. 실제로는 성공했는데. 작업자는 관리자를 부르고 작업이 멈춘다.</li>
  <li><strong>무시하면</strong>: 두 번째 스캔도 성공으로 끝난다. 결과는 똑같이 PACK이다.</li>
</ul>

<p><strong>같은 요청을 여러 번 보내도 한 번 보낸 것과 결과가 같은 성질</strong>을 <strong>멱등성(idempotency)</strong> 이라고 한다. 네트워크는 언제든 끊길 수 있으니 백엔드에서 정말 중요한 개념이다.</p>

<p>프론트에서도 이미 겪어 본 문제였다.</p>

<ul>
  <li>버튼 연타를 막으려고 <code>disabled</code> 처리를 한다. 그건 프론트 쪽 방어다. 서버는 그런 방어 없이 요청이 두 번 와도 버텨야 한다.</li>
  <li>React Query는 실패하면 자동으로 재시도한다. 서버가 멱등하지 않으면 재시도가 오히려 사고를 낸다.</li>
</ul>

<h3 id="그렇다고-무조건-무시하면">그렇다고 무조건 무시하면</h3>

<p>WAIT 상태(피킹을 시작도 안 함)에서 <code>endPicking</code>이 왔다면 그건 중복 스캔이 아니라 <strong>잘못된 요청</strong>이다. 다른 출고의 바코드를 찍었거나 버그일 수 있다. 무조건 무시하면 이런 문제도 같이 묻힌다.</p>

<p>그래서 이렇게 나누는 게 더 안전하다.</p>

<pre><code class="language-java">public void endPicking(Long userId) {
    if (this.outboundStepType == PACK) return;          // 이미 끝남 → 중복 스캔이니 무시
    if (this.outboundStepType != PICK &amp;&amp; this.outboundStepType != EXCP) {
        throw new InvalidOutboundStepException(this.id, this.outboundStepType);  // 잘못된 요청
    }
    this.outboundStepType = PACK;
    this.updatedId = userId;
}
</code></pre>

<p><strong>“이미 처리됨”과 “처리할 수 없음”을 구분하는 것</strong>이 핵심이다.</p>

<hr />

<h2 id="-출하-규칙은-배송-방법마다-다르다">⑥ 출하 규칙은 배송 방법마다 다르다</h2>

<p>PACK → SHIP으로 넘어갈 때의 규칙은 배송 방법마다 다르다.</p>

<ul>
  <li><strong>차량(TRUCK)</strong>: 패킹만 끝났으면 출하할 수 있다.</li>
  <li><strong>택배(CARRIER)</strong>: 패킹이 끝났고 <strong>송장 번호도 있어야</strong> 한다.</li>
</ul>

<p>이걸 <code>if (CARRIER) {...} else if (TRUCK) {...}</code>로 쓰지 않고, 배송 방법마다 검증 클래스를 따로 만들어 Map에 넣어 두었다.</p>

<pre><code class="language-java">// 택배용
if (!outbound.outboundStepType().equals(PACK)) throw new NotCompletePickingOutboundException(...);
if (outbound.trackingNumbers().isEmpty())       throw new NotIssuedTrackingNumberException(...);

// 차량용
if (!outbound.outboundStepType().equals(PACK)) throw new NotCompletePickingOutboundException(...);
</code></pre>

<pre><code class="language-ts">// 프론트로 치면
const validators = { TRUCK: validateTruck, CARRIER: validateCarrier };
validators[transportType](outbound);
</code></pre>

<p>나중에 퀵 배송이 생기면 클래스 하나를 만들고 Map에 한 줄만 추가하면 된다. 이런 방식을 <strong>전략 패턴</strong>이라고 한다.</p>

<hr />

<h2 id="퀴즈-풀어-보기">퀴즈 풀어 보기</h2>

<h3 id="문제-1-취소-사유를-추가해-달라는-요청이-오면">문제 1: 취소 사유를 추가해 달라는 요청이 오면?</h3>

<p>출고 취소 코드(setter 4줄)가 Service 4곳에 복사돼 있다. 기획에서 “취소할 때 취소 사유도 꼭 저장해 주세요”라는 요청이 왔다.</p>

<p>A는 복사된 곳을 전부 찾아 고쳐야 해서 한 곳이라도 빠뜨릴 위험이 있고, B는 <code>cancel()</code> 안에 한 줄만 추가하면 된다고 답했다. 여기까지는 맞았는데, B에는 장점이 하나 더 있었다. 사유를 받으려면 메서드 모양이 바뀐다.</p>

<pre><code class="language-java">public void cancel(Long userId, String reason) { ... this.cancelReason = reason; }
</code></pre>

<p>그러면 <code>cancel(userId)</code>를 부르던 4곳이 전부 <strong>컴파일 에러</strong>가 난다. 컴파일러가 고칠 곳을 빠짐없이 찾아 주는 셈이다. A는 setter 한 줄을 추가할 뿐이라 컴파일러가 아무것도 알려 주지 않는다. TS에서 함수에 필수 파라미터를 추가하면 호출하는 곳이 전부 빨간 줄이 되는 것과 같다.</p>

<h3 id="문제-2-출하-스캔이-두-번-오면">문제 2: 출하 스캔이 두 번 오면?</h3>

<p>작업자가 PDA로 출하(SHIP) 처리를 찍었는데, 와이파이가 끊겨서 한 번 더 찍었다. 출하할 때는 재고 차감도 같이 일어난다.</p>

<p>재고가 두 번 차감될 거라고 답했고, 맞았다. 출고 1건에 재고가 2번 빠진다. 선반에는 물건이 있는데 시스템에서는 없다고 나오고, 다음 주문이 “재고 부족”으로 막힌다. 막는 방법은 ⑤와 같다.</p>

<pre><code class="language-java">public void ship(Long userId) {
    if (this.outboundStepType == SHIP) return;   // 이미 출하됨 → 재고 차감까지 가지 않음
    ...
}
</code></pre>

<p>다만 이게 통하려면 <a href="/OHaEuN/27">지난 글</a>의 트랜잭션처럼 <strong>재고 차감과 단계 변경이 같은 트랜잭션 안에</strong> 있어야 한다. 그래야 두 번째 요청이 SHIP을 보고 멈춘다.</p>

<p>그리고 두 요청이 <strong>정확히 동시에</strong> 오면 둘 다 아직 PACK인 상태를 읽고 둘 다 통과할 수 있다. <a href="/OHaEuN/24">3편</a>에서 본 race condition과 같은 문제다. 이건 DB 락(lock)으로 막는다고 하는데, 나중에 따로 공부해 보려고 한다.</p>

<h3 id="문제-3-이미-완료된-출고에-피킹-완료가-오면">문제 3: 이미 완료된 출고에 피킹 완료가 오면?</h3>

<p>개선한 <code>endPicking</code>에서, 이미 <code>DONE</code>(완료)인 출고에 <code>endPicking</code>이 불리면?</p>

<p>코드대로라면 <code>InvalidOutboundStepException</code>을 던진다고 답했다. 코드만 보면 맞는 답인데, 창고 상황을 떠올려 보니 이 동작이 꼭 옳은 건 아니었다.</p>

<p>작업자 A가 피킹 완료를 찍었는데 응답이 늦어졌고, 그 사이에 작업자 B가 패킹하고 출하까지 끝냈다. 그 뒤에 A의 PDA가 재시도를 보내면 출고는 이미 <code>DONE</code>이다. 이 요청은 잘못된 요청이 아니라 <strong>늦게 도착한 중복 요청</strong>이다. 그런데 에러가 뜬다.</p>

<p>그래서 “이미 PACK이면 무시”보다 <strong>“이미 PACK 이후 단계면 무시”</strong> 가 더 정확하다.</p>

<pre><code class="language-java">if (this.outboundStepType.isAfterOrEqual(PACK)) return;   // PACK, SHIP, DONE → 이미 지나감
</code></pre>

<p>반대로 <code>CNCL</code>(취소)인 출고에 <code>endPicking</code>이 오면 진짜 문제다. 취소된 물건을 들고 다니고 있다는 뜻이니 예외로 알려야 한다.</p>

<p>기준은 <strong>“이 요청이 원하는 상태가 이미 이뤄졌는가”</strong> 다. 이뤄졌으면 무시하고, 이뤄질 수 없는 상태면 예외를 던진다.</p>

<hr />

<h2 id="정리">정리</h2>

<table>
  <thead>
    <tr>
      <th>개념</th>
      <th>WMS에서</th>
      <th>프론트 비유</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>빈약한 도메인 모델</td>
      <td>취소 Service마다 setter 4줄 복사</td>
      <td>컴포넌트마다 <code>setState</code></td>
    </tr>
    <tr>
      <td>풍부한 도메인 모델</td>
      <td><code>outbound.endPicking()</code>, <code>cancel()</code></td>
      <td>리듀서 action</td>
    </tr>
    <tr>
      <td>캡슐화</td>
      <td>setter를 막고 메서드로만 상태 변경</td>
      <td>상태를 직접 못 바꾸게 막기</td>
    </tr>
    <tr>
      <td>질문 메서드</td>
      <td><code>isPackingInProgress()</code></td>
      <td>selector</td>
    </tr>
    <tr>
      <td>멱등성</td>
      <td>같은 PDA 스캔이 두 번 와도 결과가 같게</td>
      <td>재시도해도 안전한 API</td>
    </tr>
    <tr>
      <td>전략 패턴</td>
      <td>택배/차량별 출하 검증 클래스</td>
      <td><code>switch</code> 대신 객체 조회</td>
    </tr>
  </tbody>
</table>

<p>처음엔 “이건 그냥 회사 구현 내용 아닌가” 싶었는데, 출고라는 예시를 걷어 내고 보니 남는 질문은 어느 서비스에나 있는 것이었다. <strong>규칙은 한 곳에 두고, 같은 요청이 두 번 와도 버티게 만든다.</strong> 프론트에서는 사용자 한 명의 화면만 지키면 됐지만, 서버는 네트워크가 끊기고 요청이 겹쳐 와도 데이터를 지켜야 한다는 걸 다시 느꼈다.</p>

<p>다음 글에서는 이번에 잔뜩 나온 <code>throw new ...Exception</code>이 어떻게 프론트에서 보던 <a href="/OHaEuN/29"><strong>에러 응답과 토스트 메시지</strong></a>로 바뀌는지 따라가 볼 예정이다.</p>]]></content><author><name>OHaEuN</name></author><category term="Back-end" /><category term="백엔드 입문" /><category term="도메인 모델" /><category term="멱등성" /><category term="캡슐화" /><category term="전략 패턴" /><summary type="html"><![CDATA["이 상태에서는 이걸 하면 안 된다" 같은 규칙을 코드 어디에 둘까? WMS 출고를 따라가며 빈약한/풍부한 도메인 모델, 캡슐화, 같은 요청이 두 번 와도 버티는 멱등성, 전략 패턴을 정리했다.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://ohaeun.github.io/OHaEuN/assets/posts/28/thumbnail.jpg" /><media:content medium="image" url="https://ohaeun.github.io/OHaEuN/assets/posts/28/thumbnail.jpg" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">[백엔드 입문 #5] @Transactional의 동작과 롤백 범위</title><link href="https://ohaeun.github.io/OHaEuN/27" rel="alternate" type="text/html" title="[백엔드 입문 #5] @Transactional의 동작과 롤백 범위" /><published>2026-10-29T14:45:00+09:00</published><updated>2026-10-29T14:45:00+09:00</updated><id>https://ohaeun.github.io/OHaEuN/27</id><content type="html" xml:base="https://ohaeun.github.io/OHaEuN/27"><![CDATA[<p><a href="/OHaEuN/26">지난 글</a>에서 JPA로 테이블과 객체를 연결하는 법을 정리했다. 그동안 계속 등장했지만 설명을 미뤄 둔 어노테이션이 하나 있다. 거의 모든 UseCase 메서드 위에 붙어 있던 <strong><code>@Transactional</code></strong> 이다.</p>

<blockquote>
  <p>글에 나오는 코드는 이해를 돕기 위해 일부 단순화했다.</p>
</blockquote>

<hr />

<h2 id="왜-필요할까">왜 필요할까?</h2>

<p>피처 플래그를 켜고 끄는 코드다.</p>

<pre><code class="language-java">@Transactional
public void execute(ChangeStatusFeatureFlagCommand command) {
    FeatureFlag featureFlag = findFeatureFlag.findFeatureFlag(id)
        .orElseThrow(() -&gt; new NotFoundFeatureFlagException(id));
    featureFlag.changeStatus(status, userId);                        // ① 상태 변경

    FeatureFlagHistory history = new FeatureFlagHistory(featureFlag);
    loadFeatureFlagHistory.loadFeatureFlagHistory(history);          // ② 이력 저장
}
</code></pre>

<p>DB 작업이 두 개다. ①은 성공하고 ②에서 에러가 나면? 트랜잭션이 없으면 <strong>플래그는 켜졌는데 누가 켰는지 기록은 없는</strong> 상태가 된다.</p>

<p>WMS(창고관리시스템)에서는 더 심각하다. 출고를 처리할 때 “재고 차감”과 “출고 상태를 SHIP으로 변경”이 같이 일어나야 하는데, 재고만 빠지고 출고 상태가 그대로면 <strong>물건은 사라졌는데 아직 안 보낸 주문</strong>이 생긴다.</p>

<p>트랜잭션은 여러 DB 작업을 <strong>하나로 묶어서 전부 성공하거나 전부 취소되게</strong> 한다.</p>

<table>
  <thead>
    <tr>
      <th>용어</th>
      <th>뜻</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><strong>커밋(commit)</strong></td>
      <td>묶은 작업을 DB에 확정</td>
    </tr>
    <tr>
      <td><strong>롤백(rollback)</strong></td>
      <td>묶은 작업을 전부 없던 일로</td>
    </tr>
  </tbody>
</table>

<h3 id="프론트로-비유하면-react-query의-낙관적-업데이트">프론트로 비유하면: React Query의 낙관적 업데이트</h3>

<pre><code class="language-ts">useMutation({
  onMutate: () =&gt; { /* 화면 먼저 바꿈 */ return snapshot; },
  onError: (err, vars, snapshot) =&gt; { /* 실패하면 snapshot으로 되돌림 */ },
});
</code></pre>

<p>“일단 바꾸고, 실패하면 되돌린다”는 생각은 같다. 차이는 트랜잭션이 커밋되기 전까지 <strong>다른 사용자에게 바뀐 내용이 보이지 않는다</strong>는 점이다. 낙관적 업데이트는 실패하기 전에도 화면에 이미 반영돼 있다.</p>

<hr />

<h2 id="-transactional이-실제로-하는-일">① @Transactional이 실제로 하는 일</h2>

<p>어노테이션 한 줄이 메서드를 이렇게 감싼다.</p>

<pre><code class="language-java">// Spring이 만들어 주는 코드 (개념)
트랜잭션 시작;
try {
    execute(command);      // 원래 메서드
    커밋;                   // 끝까지 오면 확정
} catch (RuntimeException e) {
    롤백;                   // 예외가 나면 전부 취소
    throw e;               // 예외는 그대로 위로 던짐
}
</code></pre>

<p><a href="/OHaEuN/24">3편</a>의 DI와 연결된다. Controller가 주입받는 UseCase는 사실 원본이 아니라, Spring이 <strong>이 try/catch로 감싼 대리 객체(프록시)</strong> 다. 프론트의 고차 함수와 같은 원리다.</p>

<pre><code class="language-ts">const withTransaction = (fn) =&gt; async (...args) =&gt; {
  begin();
  try { const r = await fn(...args); commit(); return r; }
  catch (e) { rollback(); throw e; }
};
</code></pre>

<hr />

<h2 id="-save를-안-불러도-저장된다는-정확히-언제일까">② “save를 안 불러도 저장된다”는 정확히 언제일까?</h2>

<p><a href="/OHaEuN/22">1편</a>에서 미뤄 뒀던 질문의 답은 <strong>커밋 직전</strong>이다.</p>

<pre><code>트랜잭션 시작
  │
  ├─ findFeatureFlag(id)        → SELECT, JPA가 원본 스냅샷 보관 {status: OFF}
  ├─ changeStatus("ON")         → Java 객체만 바뀜. DB는 아직 그대로
  ├─ loadFeatureFlagHistory()   → 이력 INSERT
  │
  ├─ (커밋 직전) JPA가 스냅샷과 비교: status OFF → ON 바뀜!
  │              → UPDATE feature_flag SET feature_flag_status = 'ON' ...
  │
커밋 ✅
</code></pre>

<p><code>changeStatus()</code>를 부른 순간에는 DB가 바뀌지 않는다. <strong>메서드가 끝날 때 한꺼번에</strong> 반영된다.</p>

<hr />

<h2 id="-롤백되는-예외-안-되는-예외">③ 롤백되는 예외, 안 되는 예외</h2>

<table>
  <thead>
    <tr>
      <th>예외 종류</th>
      <th>롤백?</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><code>RuntimeException</code> 계열 (unchecked)</td>
      <td>✅ 롤백</td>
    </tr>
    <tr>
      <td><code>Exception</code> 계열 (checked)</td>
      <td>❌ <strong>롤백 안 하고 커밋</strong></td>
    </tr>
  </tbody>
</table>

<p>checked 예외는 메서드 선언에 <code>throws</code>를 반드시 적어야 하는 예외다. 이건 롤백되지 않는다는 게 유명한 함정이라고 한다.</p>

<p>우리 프로젝트는 그 걱정을 덜 수 있게 만들어져 있었다.</p>

<pre><code class="language-java">public class ActiveFeatureFlagException extends AppRuleException { ... }
public class AppRuleException extends AppException { ... }
public class AppException extends RuntimeException { ... }   // ← 결국 RuntimeException
</code></pre>

<p>도메인 규칙 예외가 전부 <code>RuntimeException</code>을 상속하니까, 규칙을 어겨서 던진 예외는 항상 롤백된다.</p>

<hr />

<h2 id="-조회에는-readonly--true">④ 조회에는 readOnly = true</h2>

<pre><code class="language-java">@Transactional(readOnly = true)
public GetAllFeatureFlagResult execute() { ... }
</code></pre>

<p>“이 메서드는 읽기만 한다”는 표시다. JPA는 ②의 스냅샷 보관과 비교를 생략해서 조금 더 가벼워지고, 실수로 객체를 바꿔도 DB에 반영되지 않는다. 코드를 보면 조회(<code>Get...</code>)는 전부 <code>readOnly = true</code>, 변경(<code>Change...</code>, <code>Delete...</code>, <code>Register...</code>)은 그냥 <code>@Transactional</code>이었다.</p>

<hr />

<h2 id="-주의-트랜잭션은-db만-되돌린다">⑤ 주의: 트랜잭션은 DB만 되돌린다</h2>

<p>롤백은 <strong>우리 DB에 보낸 SQL만</strong> 취소한다. 그 밖에서 일어난 일은 되돌리지 못한다.</p>

<ul>
  <li>택배사 API를 호출해서 송장 번호를 발급받음</li>
  <li>슬랙이나 알림톡 전송</li>
  <li>다른 서버에 요청</li>
</ul>

<p>보낸 이메일을 취소할 수 없는 것처럼, 이런 건 롤백돼도 이미 일어난 일이다.</p>

<hr />

<h2 id="퀴즈-풀어-보기">퀴즈 풀어 보기</h2>

<h3 id="문제-1-이력-저장에서-예외가-나면-플래그-상태는">문제 1: 이력 저장에서 예외가 나면 플래그 상태는?</h3>

<p>맨 위의 <code>ChangeStatusFeatureFlag</code>에서 OFF → ON으로 바꾸다가 ② 이력 저장에서 예외가 났다. DB의 플래그 상태는?</p>

<p><code>@Transactional</code> 때문에 다 롤백돼서 OFF로 남는다고 답했고, 맞았다.</p>

<p>다만 더 정확히 말하면, 이 경우에는 <strong>되돌릴 UPDATE가 애초에 실행되지 않았다.</strong></p>

<pre><code>① changeStatus("ON")       → Java 객체만 바뀜. DB는 아직 OFF
② 이력 저장 중 예외 💥
   → 커밋 직전 변경 감지 단계까지 가지 못함 → UPDATE 자체가 실행 안 됨
   → 이미 실행된 SQL이 있었다면 그것도 롤백
</code></pre>

<p>결과는 같지만, 이 원리를 알면 <code>changeStatus()</code> 바로 다음 줄에서 DB를 조회해 봤을 때 아직 OFF로 나오는 이유도 이해된다.</p>

<h3 id="문제-2-택배사-api가-끼어-있으면">문제 2: 택배사 API가 끼어 있으면?</h3>

<pre><code class="language-java">@Transactional
public void ship(...) {
    stock.decrease(qty);                  // ① 재고 차감 (DB)
    courierApi.issueInvoice(outbound);    // ② 택배사 API로 송장 발급 (외부)
    outbound.changeStatus(SHIP);          // ③ 출고 상태 변경 (DB) → 여기서 예외!
}
</code></pre>

<p>이번에도 다 롤백된다고 답했는데, 절반만 맞았다. ②가 함정이었다.</p>

<table>
  <thead>
    <tr>
      <th>단계</th>
      <th>결과</th>
      <th>이유</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>① 재고 차감</td>
      <td>✅ 롤백됨</td>
      <td>같은 트랜잭션 안의 DB 작업</td>
    </tr>
    <tr>
      <td>② 송장 발급</td>
      <td>❌ <strong>그대로 남음</strong></td>
      <td>택배사 서버에서 이미 일어난 일</td>
    </tr>
    <tr>
      <td>③ 출고 상태 변경</td>
      <td>✅ 롤백됨 (애초에 반영 안 됨)</td>
      <td>예외가 난 지점</td>
    </tr>
  </tbody>
</table>

<p>택배사 API 호출은 이미 HTTP 요청을 보내고 응답까지 받은 상태다. 택배사 시스템에는 송장이 만들어져 있고, 우리 서버가 롤백해도 택배사는 그 사실을 모른다.</p>

<pre><code>우리 DB:   재고 그대로, 출고 상태 그대로  → "아직 출고 안 함"
택배사:    송장 번호 발급 완료          → "곧 택배 보낼 예정"
</code></pre>

<p>택배 기사가 물건을 가지러 왔는데 창고에서는 보낼 게 없다고 하거나, 다시 출고 처리를 하면 송장이 두 번 발급될 수 있다. 프론트로 비유하면 결제 API는 성공했는데 그 뒤 우리 서버 저장이 실패해서 <strong>돈은 나갔는데 주문은 없는</strong> 상황이다.</p>

<h3 id="그래서-실무에서는">그래서 실무에서는</h3>

<p><strong>① 외부 호출을 DB 작업 뒤로 미룬다</strong></p>

<pre><code class="language-java">@Transactional
public void ship(...) {
    stock.decrease(qty);
    outbound.changeStatus(SHIP);
}   // 커밋 성공

// 커밋이 확실히 끝난 뒤에 송장 발급
courierApi.issueInvoice(outbound);
</code></pre>

<p>DB가 실패하면 송장 발급까지 가지 않는다. 반대로 송장 발급이 실패하면 DB는 이미 SHIP이니까 “송장 재발급” 처리를 따로 해야 한다. <strong>어느 쪽이 실패해도 복구할 수 있는 쪽</strong>으로 순서를 정하는 게 핵심이다.</p>

<p><strong>② 실패하면 취소 요청을 보낸다 (보상 처리)</strong></p>

<pre><code class="language-java">try {
    ...
} catch (Exception e) {
    courierApi.cancelInvoice(invoiceNo);   // 발급했던 송장을 직접 취소
    throw e;
}
</code></pre>

<p>DB 롤백처럼 자동으로 되지 않으니, 되돌리는 코드를 직접 짠다.</p>

<hr />

<h2 id="정리">정리</h2>

<table>
  <thead>
    <tr>
      <th>개념</th>
      <th>한 줄 요약</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>트랜잭션</td>
      <td>여러 DB 작업을 묶어서 전부 성공 또는 전부 취소</td>
    </tr>
    <tr>
      <td><code>@Transactional</code></td>
      <td>메서드를 “시작 → 커밋 / 예외 시 롤백”으로 감쌈 (프록시)</td>
    </tr>
    <tr>
      <td>변경 감지 시점</td>
      <td>커밋 직전에 바뀐 필드를 UPDATE</td>
    </tr>
    <tr>
      <td>롤백 조건</td>
      <td><code>RuntimeException</code>이면 롤백</td>
    </tr>
    <tr>
      <td><code>readOnly = true</code></td>
      <td>조회 전용. 변경 감지 생략</td>
    </tr>
    <tr>
      <td>한계</td>
      <td>DB 밖의 일(외부 API, 알림)은 되돌리지 못함</td>
    </tr>
  </tbody>
</table>

<p>이번 회차에서 가장 크게 남은 건 <strong>“롤백은 우리 DB 안에서만 통한다”</strong> 는 것이다. 앞으로 외부 연동 코드를 읽을 때 “이 호출이 트랜잭션 안에 있나? 실패하면 어떻게 되지?”를 먼저 보게 될 것 같다.</p>

<p>다음 글에서는 WMS의 핵심인 <a href="/OHaEuN/28"><strong>출고(Outbound) 도메인 모델</strong></a>을 열어서, WAIT → PICK → PACK → SHIP → DONE 상태 흐름이 코드로 어떻게 지켜지는지 볼 예정이다.</p>]]></content><author><name>OHaEuN</name></author><category term="Back-end" /><category term="백엔드 입문" /><category term="트랜잭션" /><category term="Transactional" /><category term="Spring" /><category term="JPA" /><summary type="html"><![CDATA[거의 모든 UseCase 메서드 위에 붙어 있던 @Transactional을 정리했다. 트랜잭션이 하는 일, save 없이 저장되는 시점, 롤백되는 예외와 안 되는 예외, 그리고 트랜잭션이 되돌리지 못하는 외부 API 호출까지.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://ohaeun.github.io/OHaEuN/assets/posts/27/thumbnail.jpg" /><media:content medium="image" url="https://ohaeun.github.io/OHaEuN/assets/posts/27/thumbnail.jpg" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">[백엔드 입문 #4] JPA Entity 매핑과 Repository 메서드 이름 규칙</title><link href="https://ohaeun.github.io/OHaEuN/26" rel="alternate" type="text/html" title="[백엔드 입문 #4] JPA Entity 매핑과 Repository 메서드 이름 규칙" /><published>2026-10-28T18:05:00+09:00</published><updated>2026-10-28T18:05:00+09:00</updated><id>https://ohaeun.github.io/OHaEuN/26</id><content type="html" xml:base="https://ohaeun.github.io/OHaEuN/26"><![CDATA[<p><a href="/OHaEuN/24">지난 글</a>에서 Spring이 객체를 대신 만들어 연결해 주는 의존성 주입(DI)을 정리했다. 이번에는 그동안 그냥 넘어갔던 부분을 정리한다. <strong><code>existsByDetailInformationCode</code>처럼 메서드 이름만 썼는데 SQL이 실행되는 이유</strong>, 그리고 Java 객체가 DB 테이블과 어떻게 연결되는지다.</p>

<blockquote>
  <p>글에 나오는 코드는 이해를 돕기 위해 일부 단순화했다.</p>
</blockquote>

<hr />

<h2 id="jpa가-하는-일">JPA가 하는 일</h2>

<p>DB는 표(테이블)로 데이터를 저장하고, Java는 객체로 다룬다. 둘을 잇는 방법은 두 가지다.</p>

<pre><code class="language-java">// JPA 없이: SQL을 직접 쓰고, 결과를 손으로 객체에 옮김
ResultSet rs = db.query("SELECT * FROM feature_flag WHERE feature_flag_id = ?", 12);
FeatureFlag flag = new FeatureFlag();
flag.setCode(rs.getString("feature_flag_identifier_code"));
...

// JPA 사용: 객체 단위로 요청하면 SQL 생성과 변환을 대신 해 줌
FeatureFlag flag = featureFlagJpaRepository.findById(12L);
</code></pre>

<p><code>fetch</code> 응답을 손으로 파싱하는 대신 <strong>Prisma 같은 ORM</strong>을 쓰는 것과 같다. JPA도 ORM(Object-Relational Mapping)이다.</p>

<hr />

<h2 id="-테이블과-entity를-나란히-놓고-보기">① 테이블과 Entity를 나란히 놓고 보기</h2>

<p>실제 테이블 정의:</p>

<pre><code class="language-sql">CREATE TABLE `feature_flag` (
  `feature_flag_id` bigint NOT NULL AUTO_INCREMENT,
  `feature_flag_identifier_code` varchar(300) NOT NULL,
  `feature_flag_status` varchar(50) NOT NULL,
  `feature_flag_name` varchar(50) NOT NULL,
  `feature_flag_description` varchar(500) DEFAULT NULL,
  `registered_at` datetime NOT NULL,
  `created_by` bigint NOT NULL,
  `updated_by` bigint NOT NULL,
  PRIMARY KEY (`feature_flag_id`)
);
</code></pre>

<p>이 테이블과 연결된 Entity:</p>

<pre><code class="language-java">@Entity                              // "이 클래스는 테이블과 연결된다"
@Table(name = "feature_flag")        // 어떤 테이블과?
public class FeatureFlag {

    @Id                                                  // PRIMARY KEY
    @GeneratedValue(strategy = GenerationType.IDENTITY)  // AUTO_INCREMENT
    @Column(name = "feature_flag_id")
    private Long id;

    @Column(name = "created_by", nullable = false)       // created_by ↔ createdBy
    private Long createdBy;

    @Column(name = "registered_at", nullable = false)
    private LocalDateTime registeredAt;                  // datetime ↔ LocalDateTime
}
</code></pre>

<p><code>@Column(name = "...")</code>은 <strong>컬럼 이름과 필드 이름을 짝지어 준다.</strong> DB는 <code>snake_case</code>, Java는 <code>camelCase</code>를 쓰니까 연결이 필요하다. API 응답의 <code>created_by</code>를 프론트에서 <code>createdBy</code>로 바꾸는 것과 같은 일이다.</p>

<table>
  <thead>
    <tr>
      <th>MySQL</th>
      <th>Java</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><code>bigint</code></td>
      <td><code>Long</code></td>
    </tr>
    <tr>
      <td><code>varchar</code></td>
      <td><code>String</code></td>
    </tr>
    <tr>
      <td><code>datetime</code></td>
      <td><code>LocalDateTime</code></td>
    </tr>
    <tr>
      <td><code>NOT NULL</code></td>
      <td><code>nullable = false</code></td>
    </tr>
    <tr>
      <td><code>AUTO_INCREMENT</code></td>
      <td><code>@GeneratedValue(IDENTITY)</code></td>
    </tr>
  </tbody>
</table>

<p><code>id</code>가 <code>long</code>이 아니라 <code>Long</code>(대문자)인 이유도 여기서 이해됐다. <code>new FeatureFlag(...)</code>로 만든 직후에는 아직 DB에 저장되지 않아서 번호가 없다(null). 저장하는 순간 DB가 AUTO_INCREMENT로 번호를 매기고, JPA가 그 값을 <code>id</code>에 채운다.</p>

<hr />

<h2 id="-embedded-테이블은-하나-객체는-여러-개">② @Embedded: 테이블은 하나, 객체는 여러 개</h2>

<p>Entity를 보면 code, status, name 컬럼이 바로 보이지 않는다. 묶여 있다.</p>

<pre><code class="language-java">public class FeatureFlag {
    @Embedded private FeatureFlagBasicInformation basicInformation;    // name, description
    @Embedded private FeatureFlagDetailInformation detailInformation;  // code, status
}
</code></pre>

<pre><code class="language-java">@Embeddable   // "나는 독립된 테이블이 아니라, 다른 Entity에 끼워 들어간다"
public class FeatureFlagDetailInformation {

    @Column(name = "feature_flag_identifier_code", length = 300, nullable = false)
    private String code;

    @Enumerated(value = EnumType.STRING)       // enum을 "ON"/"OFF" 문자열로 저장
    @Column(name = "feature_flag_status", length = 50, nullable = false)
    private FeatureFlagStatus status;

    public FeatureFlagDetailInformation(String code) {
        validateCode(code);                    // 2~100자 검증
        this.code = code;
        this.status = FeatureFlagStatus.OFF;   // 처음엔 항상 OFF
    }
}
</code></pre>

<p>DB에서는 컬럼이 한 줄에 평평하게 나열돼 있지만, Java에서는 관련 있는 것끼리 묶었다.</p>

<pre><code>DB (평평함)                          Java (묶음)
feature_flag_identifier_code  ──┐
feature_flag_status           ──┴→  detailInformation { code, status }
feature_flag_name             ──┐
feature_flag_description      ──┴→  basicInformation { name, description }
</code></pre>

<p>평평한 API 응답을 <code>{ detail: {...}, basic: {...} }</code>로 재구성하는 것과 비슷하다. 이렇게 묶으면 “code는 2~100자” 같은 규칙을 code를 가진 객체 안에 둘 수 있다. 생성자에서 검증하니까 <strong>잘못된 code를 가진 객체는 만들어질 수조차 없다.</strong></p>

<hr />

<h2 id="-enumeratedstring을-빼먹으면">③ @Enumerated(STRING)을 빼먹으면?</h2>

<p><code>@Enumerated</code>를 생략하면 JPA는 기본값인 <code>EnumType.ORDINAL</code>을 쓴다. <strong>enum을 이름이 아니라 순서 번호로 저장하는</strong> 방식이다.</p>

<pre><code class="language-java">public enum FeatureFlagStatus {
    ON,    // 0번
    OFF;   // 1번
}
</code></pre>

<table>
  <thead>
    <tr>
      <th>방식</th>
      <th>DB에 저장되는 값</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><code>STRING</code></td>
      <td><code>"ON"</code> / <code>"OFF"</code></td>
    </tr>
    <tr>
      <td><code>ORDINAL</code> (기본값)</td>
      <td><code>0</code> / <code>1</code></td>
    </tr>
  </tbody>
</table>

<p>이미 <code>"ON"</code>으로 저장된 데이터가 있는 상태에서 이 줄을 지우면:</p>

<ol>
  <li><strong>조회할 때 에러가 난다.</strong> JPA가 <code>"ON"</code>을 숫자로 바꾸려다 실패한다.</li>
  <li><strong>더 무서운 건 저장이다.</strong> 새 플래그를 저장하면 에러 없이 <code>"1"</code>이 들어간다. 테이블에 <code>"ON"</code>, <code>"OFF"</code>, <code>"0"</code>, <code>"1"</code>이 섞인다.</li>
</ol>

<p>나중에 누군가 알아채고 <code>@Enumerated(STRING)</code>을 다시 붙여도, 이번에는 <code>"1"</code>이라는 이름의 enum이 없어서 또 에러가 난다. 그때는 코드만 고쳐서는 안 되고 DB 데이터까지 고쳐야 한다.</p>

<blockquote>
  <p>에러가 나는 버그보다 에러 없이 데이터가 이상해지는 버그가 더 위험하다.</p>
</blockquote>

<p>프론트는 새로고침하면 상태가 초기화되지만, DB에 잘못 저장된 데이터는 누군가 직접 고치기 전까지 계속 남는다. 백엔드에서 가장 크게 다르게 느낀 감각이다. 그래서 실무에서는 enum에 거의 항상 <code>STRING</code>을 쓴다고 한다. ORDINAL을 쓰면 누가 enum 순서만 바꿔도 DB 데이터의 의미가 통째로 뒤바뀐다.</p>

<hr />

<h2 id="-jparepository-인터페이스만-쓰면-구현이-생긴다">④ JpaRepository: 인터페이스만 쓰면 구현이 생긴다</h2>

<pre><code class="language-java">public interface FeatureFlagJpaRepository extends JpaRepository&lt;FeatureFlag, Long&gt; {
    //                                                    ↑ Entity    ↑ id 타입
    List&lt;FeatureFlag&gt; findAllByOrderByIdDesc();
    boolean existsByDetailInformationCode(String code);
    Optional&lt;FeatureFlag&gt; findByDetailInformationCode(String code);
}
</code></pre>

<p><code>interface</code>라서 구현이 없다. 그런데도 동작한다. <strong>서버가 켜질 때 Spring Data JPA가 구현체를 자동으로 만들어서 Bean으로 등록</strong>하기 때문이다(지난 글의 DI 덕분에 다른 곳에서 주입받아 쓸 수 있다).</p>

<p><code>JpaRepository</code>를 상속하는 것만으로 기본 메서드가 생긴다.</p>

<table>
  <thead>
    <tr>
      <th>메서드</th>
      <th>SQL</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><code>save(flag)</code></td>
      <td><code>INSERT</code> 또는 <code>UPDATE</code></td>
    </tr>
    <tr>
      <td><code>findById(12L)</code></td>
      <td><code>SELECT ... WHERE feature_flag_id = 12</code></td>
    </tr>
    <tr>
      <td><code>findAll()</code></td>
      <td><code>SELECT * FROM feature_flag</code></td>
    </tr>
    <tr>
      <td><code>delete(flag)</code></td>
      <td><code>DELETE ...</code></td>
    </tr>
  </tbody>
</table>

<h3 id="메서드-이름이-곧-쿼리">메서드 이름이 곧 쿼리</h3>

<p>직접 선언한 메서드는 <strong>이름을 문법대로 해석해서</strong> SQL을 만든다.</p>

<pre><code>existsByDetailInformationCode(String code)
└─┬──┘└┬┘└───────┬───────┘└┬─┘
 exists By  detailInformation .code
 존재여부 조건   필드 경로 (Embedded 안으로 들어감)
</code></pre>

<pre><code class="language-sql">SELECT COUNT(*) &gt; 0 FROM feature_flag
WHERE feature_flag_identifier_code = ?
</code></pre>

<p>주의할 점은 이름이 <strong>DB 컬럼명이 아니라 Java 필드 경로</strong>를 따른다는 것이다. <code>findByFeatureFlagIdentifierCode</code>라고 쓰면 그런 필드가 없어서 서버 시작 시 에러가 난다.</p>

<hr />

<h2 id="직접-만들어-보기">직접 만들어 보기</h2>

<h3 id="문제-1-on인-플래그를-전부-조회하기">문제 1: ON인 플래그를 전부 조회하기</h3>

<p>처음에는 어떻게 써야 할지 감이 오지 않았다. 이미 있는 메서드를 조금씩 고쳐 가는 방식으로 접근하니 풀렸다.</p>

<p>출발점:</p>

<pre><code class="language-java">Optional&lt;FeatureFlag&gt; findByDetailInformationCode(String code);
</code></pre>

<p><strong>1단계: 조건 필드를 code → status로 바꾼다.</strong> status도 <code>detailInformation</code> 안에 있으니 이름 끝만 바꾸고, 파라미터 타입도 status 필드 타입에 맞춘다.</p>

<pre><code class="language-java">Optional&lt;FeatureFlag&gt; findByDetailInformationStatus(FeatureFlagStatus status);
</code></pre>

<p><strong>2단계: 여러 개를 받는다.</strong> ON인 플래그는 여러 개일 수 있다. <code>Optional</code>은 “0개 또는 1개”라서 결과가 2개 이상이면 에러가 난다.</p>

<pre><code class="language-java">List&lt;FeatureFlag&gt; findAllByDetailInformationStatus(FeatureFlagStatus status);
</code></pre>

<p><code>All</code>은 읽기 쉽게 붙인 것이고, JPA는 <strong>이름보다 반환 타입을 보고</strong> 하나를 줄지 여러 개를 줄지 정한다.</p>

<pre><code class="language-sql">SELECT * FROM feature_flag WHERE feature_flag_status = 'ON'
</code></pre>

<h3 id="문제-2-off인-플래그를-최신순으로-조회하기">문제 2: OFF인 플래그를 최신순으로 조회하기</h3>

<p>기존 메서드 두 개를 합치면 된다.</p>

<pre><code class="language-java">List&lt;FeatureFlag&gt; findAllByOrderByIdDesc();
List&lt;FeatureFlag&gt; findAllByDetailInformationStatus(FeatureFlagStatus status);
</code></pre>

<p>내가 처음 쓴 답:</p>

<pre><code class="language-java">findAllByOrderByDetailInformationStatusIdDesc(FeatureFlagStatus status);
</code></pre>

<p>재료는 맞았는데 <strong>순서가 틀렸다.</strong></p>

<pre><code>내 답:  findAll By  OrderBy DetailInformationStatus IdDesc
정답:   findAll By  DetailInformationStatus  OrderBy IdDesc
                 └ 조건(WHERE) ┘        └ 정렬(ORDER BY) ┘
</code></pre>

<pre><code class="language-java">List&lt;FeatureFlag&gt; findAllByDetailInformationStatusOrderByIdDesc(FeatureFlagStatus status);
</code></pre>

<p>규칙은 SQL 순서와 같다. <strong>조건(WHERE)이 먼저, 정렬(ORDER BY)이 나중.</strong></p>

<pre><code class="language-sql">SELECT * FROM feature_flag
WHERE feature_flag_status = 'OFF'    -- By DetailInformationStatus
ORDER BY feature_flag_id DESC        -- OrderBy IdDesc
</code></pre>

<p>내 답을 JPA는 “조건 없이, <code>detailInformation.status.id</code>로 정렬”로 읽는다. status에는 <code>id</code>가 없으니 서버 시작 시 에러가 난다. 반환 타입(<code>List&lt;FeatureFlag&gt;</code>)도 빠뜨렸다. Java 메서드 선언은 항상 <code>반환타입 이름(파라미터)</code> 형태다.</p>

<h3 id="이름-짓는-공식">이름 짓는 공식</h3>

<pre><code>반환타입  find(All)  By  [조건 필드들]  OrderBy  [정렬 필드]  Asc|Desc  (파라미터)
</code></pre>

<table>
  <thead>
    <tr>
      <th>결과</th>
      <th>반환 타입</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>하나 (없을 수도 있음)</td>
      <td><code>Optional&lt;X&gt;</code></td>
    </tr>
    <tr>
      <td>여러 개</td>
      <td><code>List&lt;X&gt;</code></td>
    </tr>
    <tr>
      <td>있는지만 확인</td>
      <td><code>boolean</code> (<code>existsBy</code>)</td>
    </tr>
  </tbody>
</table>

<p>조건이 여러 개면 <code>And</code>로 잇는다. 다만 이름이 너무 길어지면 읽기 어려워서, 조건이 복잡하면 <code>@Query</code>나 QueryDSL로 쿼리를 직접 쓴다고 한다. 메서드 이름 방식은 <strong>조건 1~2개짜리 간단한 조회용</strong>이다.</p>

<hr />

<h2 id="-테이블은-누가-만들까-flyway-마이그레이션">⑤ 테이블은 누가 만들까? Flyway 마이그레이션</h2>

<p>JPA가 테이블을 자동으로 만들 수도 있지만, 실무 프로젝트에서는 <strong>SQL 파일로 직접 관리</strong>하고 있었다.</p>

<pre><code>src/main/resources/db/migration/
  V202605200001__initial_schema.sql              ← 초기 테이블
  V202607020001__add_featureflag_deleted_at.sql  ← 나중에 컬럼 추가
</code></pre>

<p>파일 이름 앞의 <code>V날짜번호</code>가 버전이고, Flyway라는 도구가 아직 실행 안 된 파일을 순서대로 DB에 적용한다. <strong>DB용 git 커밋 기록</strong>이라고 생각하면 된다.</p>

<p>재미있던 점: 초기 스키마의 <code>feature_flag</code> 테이블에는 <code>deleted_at</code> 컬럼이 없었다. soft delete는 나중에 추가됐고, 그때 이 파일이 생겼다.</p>

<pre><code class="language-sql">ADD COLUMN deleted_at datetime DEFAULT NULL COMMENT '삭제일시';
...
ADD UNIQUE KEY uk_feature_flag_01 (feature_flag_identifier_code, (if(deleted_at is null, true, null)));
</code></pre>

<p>마지막 줄은 “code는 중복되면 안 되는데, <strong>삭제된 것끼리는 중복돼도 된다</strong>“는 제약이다. soft delete는 지운 행이 남아 있어서, 같은 code로 새 플래그를 만들면 DB가 중복이라고 막는다. 그 문제를 해결한 것이다. <a href="/OHaEuN/22">1편</a>에서 본 soft delete가 DB 설계에도 영향을 준 사례다.</p>

<p>그리고 <strong>Entity에 필드를 추가하는 것만으로는 DB가 바뀌지 않는다.</strong> 컬럼을 추가하려면 마이그레이션 SQL과 Entity 필드를 둘 다 바꿔야 한다. 프론트에서 API 응답 타입만 바꿔도 서버 응답은 안 바뀌는 것과 같다.</p>

<hr />

<h2 id="정리">정리</h2>

<table>
  <thead>
    <tr>
      <th>개념</th>
      <th>하는 일</th>
      <th>프론트 비유</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><code>@Entity</code> + <code>@Table</code></td>
      <td>클래스 ↔ 테이블 연결</td>
      <td>Prisma model</td>
    </tr>
    <tr>
      <td><code>@Column(name=...)</code></td>
      <td>필드 ↔ 컬럼 연결</td>
      <td>snake → camel 변환</td>
    </tr>
    <tr>
      <td><code>@Embedded</code> / <code>@Embeddable</code></td>
      <td>컬럼 여러 개를 객체 하나로 묶음</td>
      <td>평평한 응답을 중첩 객체로 재구성</td>
    </tr>
    <tr>
      <td><code>@Enumerated(STRING)</code></td>
      <td>enum을 이름으로 저장</td>
      <td>—</td>
    </tr>
    <tr>
      <td><code>JpaRepository</code></td>
      <td>기본 CRUD 자동 제공</td>
      <td>자동 생성된 API 클라이언트</td>
    </tr>
    <tr>
      <td><code>findBy...</code> 이름</td>
      <td>이름으로 쿼리 생성</td>
      <td>—</td>
    </tr>
    <tr>
      <td>Flyway 마이그레이션</td>
      <td>테이블 구조 변경 이력</td>
      <td>DB용 git 커밋</td>
    </tr>
  </tbody>
</table>

<p>다음 글에서는 <a href="/OHaEuN/27"><strong>트랜잭션(<code>@Transactional</code>)</strong></a>을 정리한다. save를 안 불러도 저장되는 변경 감지가 정확히 언제 일어나는지, 중간에 에러가 나면 왜 앞에서 저장한 것까지 취소되는지 알아볼 예정이다.</p>]]></content><author><name>OHaEuN</name></author><category term="Back-end" /><category term="백엔드 입문" /><category term="JPA" /><category term="Spring Data JPA" /><category term="Flyway" /><category term="Java" /><summary type="html"><![CDATA[지난 글에서 Spring이 객체를 대신 만들어 연결해 주는 의존성 주입(DI)을 정리했다. 이번에는 메서드 이름만 썼는데 SQL이 실행되는 이유, 그리고 Java 객체가 DB 테이블과 어떻게 연결되는지 JPA를 정리한다.]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://ohaeun.github.io/OHaEuN/assets/posts/26/thumbnail.jpg" /><media:content medium="image" url="https://ohaeun.github.io/OHaEuN/assets/posts/26/thumbnail.jpg" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">Web Locks를 검토하며 정리한 브라우저 저장소 경계</title><link href="https://ohaeun.github.io/OHaEuN/25" rel="alternate" type="text/html" title="Web Locks를 검토하며 정리한 브라우저 저장소 경계" /><published>2026-10-27T20:00:00+09:00</published><updated>2026-10-27T20:00:00+09:00</updated><id>https://ohaeun.github.io/OHaEuN/25</id><content type="html" xml:base="https://ohaeun.github.io/OHaEuN/25"><![CDATA[<p>같은 사이트를 같은 브라우저에서 열었는데도 저장소를 공유하지 않는 경우가 있다. 그 경계를 정하는 게 <strong>브라우저 프로필</strong>이다.</p>

<p>업무에서 사용자가 여러 창을 띄워 같은 작업을 동시에 진행하다가 브라우저 스토리지의 데이터가 꼬이는 문제를 다룬 적이 있다. 해결책으로 Web Locks API(<code>navigator.locks</code>)를 검토하면서 “이 락은 정확히 어디까지 공유되지?”를 따라가 봤다. 처음에는 origin만 같으면 되는 줄 알았는데, 파고들수록 프로필, 시크릿 창, 컨테이너 탭 같은 경계가 여러 겹으로 나왔다.</p>

<p>이번 글에서는 브라우저가 저장소를 어떤 단위로 나누는지, 그중 프로필이 정확히 무엇이고 브라우저마다 어떻게 다른지, 그리고 웹 개발자 입장에서 무엇을 신경 써야 하는지 정리했다.</p>

<hr />

<h2 id="-저장소-경계는-네-겹이다">① 저장소 경계는 네 겹이다</h2>

<p>브라우저가 탭에 저장소를 나눠 주는 경계는 바깥부터 <strong>브라우저 설치 → 프로필 → 브라우징 컨텍스트 → 스토리지 키</strong> 순서다. 두 탭은 이 네 가지가 <strong>모두 같아야</strong> 같은 저장소를 쓴다.</p>

<figure class="diagram" aria-label="브라우저 저장소 경계 다이어그램: 브라우저 설치 안에 프로필, 그 안에 브라우징 컨텍스트, 그 안에 스토리지 키가 있고, 가장 안쪽에서 localStorage, IndexedDB, BroadcastChannel, Web Locks를 공유한다">
<svg viewBox="0 0 640 360" xmlns="http://www.w3.org/2000/svg" role="img" style="width:100%;height:auto;font-family:inherit">
  <rect x="4" y="4" width="632" height="352" rx="18" style="fill:var(--bg-soft);stroke:var(--border-strong)" />
  <text x="26" y="40" style="fill:var(--text-strong);font-size:17px;font-weight:700">브라우저 설치</text>
  <text x="152" y="40" style="fill:var(--text-muted);font-size:14px">Chrome, Edge, Firefox는 서로 완전히 별개</text>
  <rect x="26" y="58" width="588" height="280" rx="14" style="fill:var(--bg);stroke:var(--border-strong)" />
  <text x="48" y="92" style="fill:var(--text-strong);font-size:17px;font-weight:700">프로필</text>
  <text x="112" y="92" style="fill:var(--text-muted);font-size:14px">Default, Profile 1 … 디스크 위의 폴더</text>
  <rect x="48" y="110" width="544" height="210" rx="12" style="fill:var(--bg-soft);stroke:var(--border-strong)" />
  <text x="70" y="144" style="fill:var(--text-strong);font-size:17px;font-weight:700">브라우징 컨텍스트</text>
  <text x="222" y="144" style="fill:var(--text-muted);font-size:14px">일반 창 / 시크릿·게스트 / 컨테이너 탭</text>
  <rect x="70" y="162" width="500" height="140" rx="10" style="fill:var(--bg);stroke:var(--border-strong)" />
  <text x="92" y="196" style="fill:var(--text-strong);font-size:17px;font-weight:700">스토리지 키</text>
  <text x="190" y="196" style="fill:var(--text-muted);font-size:14px">(최상위 사이트, 프레임 origin)</text>
  <rect x="92" y="216" width="456" height="64" rx="10" style="fill:var(--accent-soft)" />
  <text x="320" y="244" text-anchor="middle" style="fill:var(--accent);font-size:15px;font-weight:700">여기까지 같아야 공유</text>
  <text x="320" y="266" text-anchor="middle" style="fill:var(--accent);font-size:13px">localStorage · IndexedDB · BroadcastChannel · Web Locks</text>
</svg>
</figure>

<p>하나라도 다르면 localStorage도, Web Locks도 공유되지 않는다. 바깥 층부터 하나씩 살펴보자.</p>

<hr />

<h2 id="-프로필의-정체-디스크-위의-폴더-하나">② 프로필의 정체: 디스크 위의 폴더 하나</h2>

<p>결론부터 말하면 <strong>프로필은 디스크에 있는 폴더 하나</strong>다. 그 폴더가 쿠키, localStorage, IndexedDB 같은 사이트 데이터를 통째로 들고 있다.</p>

<p>Chromium 문서를 보면 user data 디렉터리에는 방문 기록, 북마크, 쿠키 같은 프로필 데이터와 설치 단위의 로컬 상태가 들어 있고, 각 프로필은 그 아래의 하위 폴더(보통 <code>Default</code>)다. 프로필을 추가하면 <code>Profile 1</code>, <code>Profile 2</code> 같은 폴더가 생긴다.</p>

<table>
  <thead>
    <tr>
      <th>OS</th>
      <th>Chrome user data 디렉터리 기본 위치</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Windows</td>
      <td><code>%LOCALAPPDATA%\Google\Chrome\User Data</code></td>
    </tr>
    <tr>
      <td>macOS</td>
      <td><code>~/Library/Application Support/Google/Chrome</code></td>
    </tr>
    <tr>
      <td>Linux</td>
      <td><code>~/.config/google-chrome</code></td>
    </tr>
  </tbody>
</table>

<p>지금 쓰는 탭이 어느 프로필인지는 주소창에 <code>chrome://version</code>을 입력해 <strong>“프로필 경로”</strong> 항목을 보면 바로 알 수 있다.</p>

<h3 id="구글-계정-로그인과는-별개다">구글 계정 로그인과는 별개다</h3>

<p>나도 처음엔 “프로필 = 구글 계정”이라고 생각했는데, 그렇지 않았다. 계정에 로그인하지 않아도 Chrome은 처음부터 <code>Default</code> 프로필로 동작한다. Google 도움말도 프로필을 북마크, 방문 기록, 비밀번호, 설정을 분리하는 수단으로 설명하고, 계정 로그인은 그 데이터를 다른 기기와 동기화하는 선택 사항으로 다룬다.</p>

<p>즉 <strong>로그인은 프로필 위에 동기화를 얹는 기능일 뿐</strong>이고, 저장소가 나뉘는 단위에는 영향을 주지 않는다. 프로필을 삭제하면 그 프로필의 데이터가 컴퓨터에서 지워진다는 점도 “프로필 = 로컬 폴더”라는 걸 보여준다.</p>

<h3 id="브라우저-내부에서는">브라우저 내부에서는</h3>

<p>Chromium 코드에서 프로필 하나는 <code>BrowserContext</code>에 대응한다. 그 안에서 실제 저장소를 관리하는 게 <code>StoragePartition</code>인데, 소스 주석은 이를 “각 자식(렌더러) 프로세스가 BrowserContext 안의 영속 상태를 바라보는 뷰”라고 정의한다.</p>

<p><code>StoragePartitionImpl</code>은 DOM Storage(localStorage), IndexedDB, Cache Storage, Service Worker, BroadcastChannel 같은 컨텍스트를 함께 들고 있다. 탭은 생성될 때 어느 BrowserContext 소속인지 정해지고, <strong>같은 객체를 바라보는 탭끼리만</strong> 이 저장소들을 공유한다.</p>

<pre><code>BrowserContext (프로필)
└── StoragePartition
    ├── DOM Storage (localStorage)
    ├── IndexedDB
    ├── Cache Storage
    ├── Service Worker
    └── BroadcastChannel
</code></pre>

<p>같은 user data 디렉터리로 Chrome을 한 번 더 실행하면 새 프로세스가 아니라 이미 떠 있는 브라우저로 요청이 넘겨진다. 반대로 <code>--user-data-dir</code> 플래그로 다른 폴더를 지정하면 완전히 별개의 브라우저 인스턴스가 된다.</p>

<hr />

<h2 id="-시크릿-창과-게스트-모드-잠깐-쓰고-버리는-컨텍스트">③ 시크릿 창과 게스트 모드: 잠깐 쓰고 버리는 컨텍스트</h2>

<p>시크릿 창과 게스트 모드는 각각 일반 프로필과 분리된 별도의 저장소를 쓰고, <strong>세션이 끝나면 그 저장소를 통째로 버린다.</strong></p>

<h3 id="시크릿-창">시크릿 창</h3>

<p>시크릿 창을 열면 Chrome은 별도의 브라우징 세션을 시작하고, 이 세션은 <strong>시크릿 창을 전부 닫아야</strong> 끝난다. 세션 동안에는 사이트가 동작하도록 쿠키와 사이트 데이터를 임시로 보관하고, 세션이 끝나면 지운다. 시크릿 창을 하나 더 열면 새 세션이 아니라 기존 시크릿 세션이 그대로 이어진다.</p>

<p>웹 개발자 관점에서 정리하면 이렇다.</p>

<ul>
  <li>같은 프로필에서 연 시크릿 창끼리는 localStorage, IndexedDB, Web Locks를 <strong>공유한다.</strong></li>
  <li>시크릿 창과 일반 창은 서로 <strong>공유하지 않는다.</strong></li>
  <li>마지막 시크릿 창을 닫는 순간 전부 사라지고, 다음에 여는 시크릿 창은 빈 상태에서 시작한다.</li>
</ul>

<p>Chromium 내부에서 시크릿 세션은 각 일반 프로필에 딸린 off-the-record 프로필로 구현된다. 그래서 프로필이 두 개면 시크릿 세션도 프로필마다 따로 생긴다.</p>

<h3 id="게스트-모드">게스트 모드</h3>

<p>게스트 모드는 <strong>어느 프로필에도 속하지 않는</strong> 독립된 임시 컨텍스트다. 게스트 모드에서는 다른 프로필의 정보를 보거나 바꿀 수 없고, 게스트 창을 닫으면 방문 기록, 쿠키, 사이트 데이터가 삭제된다.</p>

<p>게스트 창 안에서 연 탭끼리는 저장소와 락을 정상적으로 공유한다.</p>

<blockquote>
  <p>“게스트라서 Web Locks가 안 된다”가 아니라, <strong>“게스트 창끼리만 공유된다”</strong>가 정확한 표현이다.</p>
</blockquote>

<hr />

<h2 id="-브라우저별-차이">④ 브라우저별 차이</h2>

<p>“프로필로 저장소를 나눈다”는 큰 틀은 같지만, 그 안에서 추가로 나누는 장치와 프라이빗 모드의 동작은 브라우저마다 다르다. 특히 <strong>Safari 개인정보 보호 브라우징은 탭끼리도 저장소를 공유하지 않는다.</strong></p>

<table>
  <thead>
    <tr>
      <th>브라우저</th>
      <th>프로필 단위</th>
      <th>프라이빗 모드</th>
      <th>그 밖의 분리 장치</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Chrome</td>
      <td>user data 디렉터리 아래 폴더 하나</td>
      <td>같은 프로필의 시크릿 창끼리 공유, 모두 닫으면 삭제</td>
      <td>게스트 모드</td>
    </tr>
    <tr>
      <td>Edge</td>
      <td>Chrome과 동일한 Chromium 구조</td>
      <td>InPrivate, 시크릿과 같은 개념</td>
      <td>자동 프로필 전환, IE 모드, WebView2</td>
    </tr>
    <tr>
      <td>Firefox</td>
      <td><code>profiles.ini</code>에 등록된 프로필 폴더</td>
      <td>사생활 보호 창, 저장소 키에 표시가 붙어 분리</td>
      <td>컨테이너 탭</td>
    </tr>
    <tr>
      <td>Safari</td>
      <td>Safari 17부터 프로필 지원</td>
      <td>개인정보 보호 브라우징, <strong>탭마다 격리</strong></td>
      <td>없음</td>
    </tr>
  </tbody>
</table>

<h3 id="edge">Edge</h3>

<p>Edge는 Chromium 기반이라 프로필, InPrivate, 게스트의 구조가 Chrome과 같다. 디스크 위치만 <code>%LOCALAPPDATA%\Microsoft\Edge\User Data</code>로 다르다. 그래서 같은 PC에서 Chrome과 Edge로 같은 사이트를 열어도 두 탭은 서로를 전혀 모른다.</p>

<p>Edge에서 특히 눈여겨볼 기능은 <strong>자동 프로필 전환(Automatic Profile Switching)</strong>이다. 개인 프로필에서 회사·학교 계정으로 인증하는 사이트에 들어가면, Edge가 이를 감지해 회사 프로필로 전환하라고 안내하고 선택한 프로필에서 사이트를 연다. 외부 앱에서 여는 링크를 어느 프로필로 열지 기본값도 정할 수 있다.</p>

<p>사용자 입장에서는 “같은 Edge”지만 실제로는 다른 프로필이라 저장소가 공유되지 않는 상황이 생길 수 있다. 사내 업무용 서비스라면 충분히 만날 수 있는 경우라서 기억해 둘 만하다.</p>

<p>그 밖에도 알아둘 것이 두 가지 있다.</p>

<ul>
  <li><strong>IE 모드 탭</strong>은 Chromium이 아니라 예전 IE 엔진으로 렌더링되고 저장소도 별개라서, <code>navigator.locks</code> 같은 최신 API 자체가 없다.</li>
  <li>Edge 엔진을 앱에 임베드하는 <strong>WebView2</strong>는 user data 폴더(UDF)에 쿠키, 권한, 캐시 같은 데이터를 저장한다. 하나의 UDF 아래 여러 프로필을 둘 수 있고, 프로필마다 전용 폴더가 생겨 데이터가 분리된다. 결국 Edge 브라우저와 WebView2 앱, 그리고 WebView2 앱끼리도 기본적으로 저장소를 공유하지 않는다.</li>
</ul>

<h3 id="firefox">Firefox</h3>

<p>Firefox도 가장 바깥 단위는 프로필 폴더다. 흥미로운 건 그 안에서 저장소를 나누는 방식이다.</p>

<p>Firefox는 origin에 <code>OriginAttributes</code>라는 꼬리표를 붙여, <strong>origin이 같아도 다른 보안 컨텍스트로 구분한다.</strong> 여기에는 이런 값들이 들어간다.</p>

<ul>
  <li><code>userContextId</code>: 컨테이너 탭</li>
  <li><code>privateBrowsingId</code>: 사생활 보호 모드 여부</li>
  <li><code>partitionKey</code>: 스토리지 파티셔닝</li>
</ul>

<p>컨테이너 탭은 이 구조를 사용자에게 드러낸 기능이다. 각 컨테이너 탭은 쿠키와 localStorage 같은 저장소를 다른 컨테이너와 따로 쓴다. 즉 Firefox에서는 <strong>같은 프로필, 같은 창 안에서도 컨테이너가 다르면 저장소가 분리된다.</strong></p>

<h3 id="safari">Safari</h3>

<p>Safari는 17부터 프로필을 지원한다. 프로필마다 방문 기록, 쿠키, 웹사이트 데이터, 확장 프로그램, 탭 그룹, 즐겨찾기가 따로 있고, 처음 프로필을 만들면 기존 데이터는 “개인”이라는 기본 프로필로 들어간다.</p>

<p>정리하면서 가장 놀랐던 부분은 개인정보 보호 브라우징이었다. Apple 도움말은 <strong>개인정보 보호 브라우징 창의 각 탭이 서로 격리되어 있다</strong>고 설명한다. Chrome 시크릿 창에서는 탭끼리 저장소를 공유하지만, Safari 개인정보 보호 브라우징에서는 같은 사이트를 탭 두 개로 열어도 서로 다른 저장소를 쓴다. 이 경우 Web Locks로 탭끼리 조율하려는 시도는 애초에 성립하지 않는다.</p>

<hr />

<h2 id="-프로필-안에서-한-번-더-스토리지-파티셔닝">⑤ 프로필 안에서 한 번 더: 스토리지 파티셔닝</h2>

<p>같은 프로필 안에서도 저장소는 origin 하나가 아니라 <strong>(최상위 사이트, 프레임 origin) 조합</strong>으로 다시 나뉜다. 이걸 스토리지 파티셔닝이라고 부른다.</p>

<p>파티셔닝 이전에는 서드파티 iframe이 어느 사이트에 임베드되든 같은 저장소를 써서, 여러 사이트를 넘나드는 추적에 악용될 수 있었다. 지금 Chrome에서는 데이터가 origin도 같고 최상위 사이트도 같은 컨텍스트에서만 보인다.</p>

<pre><code>https://app.example.com 을 탭에서 직접 열면
  → 키: (example.com, app.example.com)

같은 페이지가 https://partner.com 안의 iframe으로 열리면
  → 키: (partner.com, app.example.com)   ← 위의 탭과 저장소·락 공유 안 함
</code></pre>

<p>A 사이트 안에 B iframe이 있고, 그 안에 다시 A iframe이 있는 경우도 있다. 최상위와 현재 프레임만 보면 안쪽 A가 1st-party처럼 보이기 때문에, Chrome은 중간에 cross-site 문서가 끼어 있으면 켜지는 <strong>“ancestor bit”</strong>를 키에 추가로 넣는다.</p>

<p>파티셔닝 대상에는 Web Storage, IndexedDB, Cache Storage, BroadcastChannel, SharedWorker, Web Locks 등이 포함된다. 다만 대부분의 서비스처럼 내 사이트를 최상위 탭으로 여는 경우에는 키가 언제나 같으니, <strong>실무에서 이 층이 문제가 되는 건 다른 사이트에 iframe으로 임베드될 때뿐</strong>이다.</p>

<hr />

<h2 id="-웹-개발자에게-의미하는-것">⑥ 웹 개발자에게 의미하는 것</h2>

<p>탭끼리 무언가를 공유하는 브라우저 API는 전부 저장소 경계를 그대로 따른다. 그래서 <strong>“이 API는 어디까지 닿는가”는 “이 탭들이 같은 저장소를 쓰는가”와 같은 질문</strong>이다.</p>

<h3 id="web-locks는-저장소-버킷-단위다">Web Locks는 저장소 버킷 단위다</h3>

<p>Web Locks 명세는 락 조율이 <strong>같은 저장소 버킷을 공유하는 에이전트(탭, iframe, 워커) 사이에서</strong> 이루어진다고 정의한다. 각 저장소 버킷은 락 매니저를 하나씩 가지고, 같은 버킷을 쓰는 페이지와 워커는 서로 무관한 창이어도 락 매니저를 공유한다.</p>

<p>이 정의 덕분에 앞에서 본 모든 경계가 락에도 그대로 적용된다. 아래 경우는 모두 락을 공유하지 않는다.</p>

<ul>
  <li>다른 프로필</li>
  <li>시크릿·InPrivate 창, 게스트 창</li>
  <li>Firefox의 다른 컨테이너</li>
  <li>Safari 개인정보 보호 브라우징의 다른 탭</li>
  <li>cross-site iframe</li>
</ul>

<p>localStorage, IndexedDB, BroadcastChannel도 마찬가지다.</p>

<h3 id="경계가-같아서-오히려-안전한-경우">경계가 같아서 오히려 안전한 경우</h3>

<p>락이 닿지 않는 곳에는 보통 보호할 공유 자원도 없다. 예를 들어 여러 탭에서 토큰 갱신이 동시에 일어나는 걸 Web Locks로 막는다고 해보자.</p>

<p>게스트 창의 탭들은 게스트 창의 토큰을 같이 쓰고 락도 그 탭들끼리 공유하니, 딱 보호해야 할 범위를 보호한다. 일반 창의 탭은 애초에 토큰이 따로라서 게스트 탭과 경쟁할 일이 없다. <strong>저장소 경계와 락의 경계가 같기 때문에 오히려 자연스럽게 맞아떨어지는 셈</strong>이다.</p>

<h3 id="경계-밖의-동시성은-서버-몫이다">경계 밖의 동시성은 서버 몫이다</h3>

<p>문제는 보호하려는 자원이 브라우저 밖에 있을 때다. “같은 작업 건은 한 화면에서만 편집해야 한다” 같은 요구사항이라면, 같은 계정으로 다른 프로필이나 다른 브라우저, 다른 PC에서 들어오는 경우를 프론트에서는 막을 수 없다.</p>

<blockquote>
  <p>이런 경우는 <strong>서버에서 버전 체크(낙관적 락)나 상태 체크로 막아야 한다.</strong> 이번에 가장 크게 느낀 부분도 이거였다. 프론트에서 할 수 있는 조율에는 분명한 경계가 있다.</p>
</blockquote>

<h3 id="js로-같은-저장소인가-확인하기">JS로 “같은 저장소인가” 확인하기</h3>

<p>웹 페이지가 “지금 몇 번 프로필이다”를 알아낼 방법은 없다. 프라이버시 때문에 의도적으로 노출하지 않는다. 대신 실제로 공유되는지는 직접 확인할 수 있다.</p>

<pre><code class="language-javascript">// 창 A: 락을 잡고 놓지 않는다
navigator.locks.request('probe', () =&gt; new Promise(() =&gt; {}));

// 창 B: 같은 저장소라면 held 목록에 'probe'가 보인다
const { held } = await navigator.locks.query();
console.log(held.some((l) =&gt; l.name === 'probe'));
</code></pre>

<p>BroadcastChannel로 메시지를 보내서 다른 창이 받는지 보는 것도 같은 원리다. 디버깅할 때 “왜 이 두 창은 락을 공유하지 않지?” 싶으면 이 방법으로 <strong>먼저 같은 저장소인지부터 확인</strong>하면 된다.</p>

<hr />

<h2 id="정리">정리</h2>

<p>“같은 브라우저에서 열었으니 저장소도 같겠지”라는 가정은 생각보다 자주 틀린다.</p>

<table>
  <thead>
    <tr>
      <th>경계</th>
      <th>이게 다르면 저장소가 갈린다</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>브라우저 설치</td>
      <td>Chrome ↔ Edge, <code>--user-data-dir</code>로 띄운 별도 인스턴스</td>
    </tr>
    <tr>
      <td>프로필</td>
      <td>Default ↔ Profile 1, Edge 자동 프로필 전환</td>
    </tr>
    <tr>
      <td>브라우징 컨텍스트</td>
      <td>일반 ↔ 시크릿·게스트, Firefox 컨테이너, Safari 개인정보 보호 탭</td>
    </tr>
    <tr>
      <td>스토리지 키</td>
      <td>직접 연 탭 ↔ 다른 사이트에 임베드된 iframe</td>
    </tr>
  </tbody>
</table>

<blockquote>
  <p><strong>브라우저 API로 조율할 수 있는 건 같은 저장소를 쓰는 탭까지이고, 그 밖의 동시성은 서버가 책임져야 한다.</strong> 그리고 디버깅할 때는 “두 창이 정말 같은 저장소를 쓰고 있는가”부터 확인하는 게 빠르다.</p>
</blockquote>

<hr />

<h2 id="참고-자료">참고 자료</h2>

<ul>
  <li><a href="https://chromium.googlesource.com/chromium/src.git/+/refs/heads/master/docs/user_data_dir.md">User Data Directory — Chromium docs</a></li>
  <li><a href="https://chromium.googlesource.com/chromium/src/+/404ca6f/content/public/browser/storage_partition.h">storage_partition.h — Chromium source</a></li>
  <li><a href="https://support.google.com/chrome/answer/2364824">Manage Chrome with multiple profiles — Google Chrome Help</a></li>
  <li><a href="https://support.google.com/chrome/answer/95464">Browse in Incognito mode — Google Chrome Help</a></li>
  <li><a href="https://support.google.com/chrome/answer/6130773">Browse Chrome as a guest — Google Chrome Help</a></li>
  <li><a href="https://blogs.windows.com/msedgedev/2020/04/30/automatic-profile-switching/">Automatic profile switching — Microsoft Edge Blog</a></li>
  <li><a href="https://learn.microsoft.com/microsoft-edge/webview2/concepts/multi-profile-support">Support multiple profiles under a single user data folder — WebView2 docs</a></li>
  <li><a href="https://firefox-source-docs.mozilla.org/content-security/index.html">Web Security Checks in Gecko — Firefox source docs</a></li>
  <li><a href="https://support.mozilla.org/en-US/kb/containers">Multi-Account Containers — Mozilla Support</a></li>
  <li><a href="https://support.apple.com/en-us/105100">Use profiles in Safari on Mac — Apple Support</a></li>
  <li><a href="https://help.apple.com/safari/mac/10.0/en.lproj/ibrw1069.html">Safari Help: Private Browsing</a></li>
  <li><a href="https://developer.chrome.com/docs/privacy-sandbox/storage-partitioning">Storage Partitioning — Chrome for Developers</a></li>
  <li><a href="https://github.com/privacycg/storage-partitioning">privacycg/storage-partitioning — GitHub</a></li>
  <li><a href="https://w3c.github.io/web-locks/">Web Locks API — W3C</a></li>
</ul>]]></content><author><name>OHaEuN</name></author><category term="Front-end" /><category term="Web Locks" /><category term="브라우저 프로필" /><category term="localStorage" /><category term="스토리지 파티셔닝" /><category term="시크릿 모드" /><summary type="html"><![CDATA[같은 사이트를 같은 브라우저에서 열었는데도 저장소를 공유하지 않는 경우가 있다. 그 경계를 정하는 게 브라우저 프로필이다. 업무에서 사용자가 여러 창을 띄워 같은 작업을 동시에 진행하다가 브라우저 스토리지의 데이터가 꼬이는 문제를 다룬 적이 있다. 해결책으로 Web Locks…]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://ohaeun.github.io/OHaEuN/assets/img/icon-512.png" /><media:content medium="image" url="https://ohaeun.github.io/OHaEuN/assets/img/icon-512.png" xmlns:media="http://search.yahoo.com/mrss/" /></entry><entry><title type="html">[백엔드 입문 #3] Spring 의존성 주입과 Bean 싱글톤</title><link href="https://ohaeun.github.io/OHaEuN/24" rel="alternate" type="text/html" title="[백엔드 입문 #3] Spring 의존성 주입과 Bean 싱글톤" /><published>2026-10-26T18:35:58+09:00</published><updated>2026-10-27T17:21:43+09:00</updated><id>https://ohaeun.github.io/OHaEuN/24</id><content type="html" xml:base="https://ohaeun.github.io/OHaEuN/24"><![CDATA[<p>지난 글에서 Java 문법을 정리하면서 계속 마음에 걸리는 코드가 있었다.</p>

<pre><code>@UseCase
@RequiredArgsConstructor
public class DeleteFeatureFlag {
    private final FindFeatureFlag findFeatureFlag;   // 선언만 함

    public void execute(DeleteFeatureFlagCommand command) {
        findFeatureFlag.findFeatureFlag(...);         // 바로 사용함
    }
}
</code></pre>

<p><code>final</code> 필드는 생성자에서 반드시 값을 넣어야 한다. 그런데 <strong>생성자도 없고, <code>new DeleteFeatureFlag(...)</code>를 부르는 곳도 없다.</strong> 그런데도 null이 아니다. 이 두 가지를 각각 다른 도구가 대신해 준다.</p>

<hr />

<h2 id="-생성자는-lombok이-만든다">① 생성자는 Lombok이 만든다</h2>

<p><code>@RequiredArgsConstructor</code>는 “<code>final</code> 필드를 모두 받는 생성자를 만들어줘”라는 뜻이다. 컴파일하면 실제로 아래 코드가 생긴다.</p>

<pre><code>public DeleteFeatureFlag(UserApplicationService userService,
                         FindFeatureFlag findFeatureFlag,
                         FindUserFeatureFlagRelation findUserFeatureFlagRelation,
                         LoadFeatureFlagHistory loadFeatureFlagHistory) {
    this.userService = userService;
    this.findFeatureFlag = findFeatureFlag;
    ...
}
</code></pre>

<hr />

<h2 id="-생성자-호출은-spring이-한다">② 생성자 호출은 Spring이 한다</h2>

<p>서버가 시작될 때 Spring이 하는 일은 이렇다.</p>

<ol>
  <li><strong>찾기</strong>: <code>@Component</code>가 붙은 클래스를 전부 찾는다.</li>
  <li><strong>분석</strong>: 각 생성자를 보고 무엇이 필요한지 파악한다.</li>
  <li><strong>조립</strong>: 필요한 것부터 <code>new</code> 해서 생성자에 넣어준다.</li>
</ol>

<p>이렇게 Spring이 만들어 관리하는 객체를 <strong>Bean</strong>이라고 부른다.</p>

<p>그런데 <code>DeleteFeatureFlag</code>에는 <code>@Component</code>가 아니라 <code>@UseCase</code>가 붙어 있었다. 정의를 열어 보면:</p>

<pre><code>@Component
public @interface UseCase {}
</code></pre>

<p><code>@UseCase</code>는 <strong><code>@Component</code>인데 이름만 바꿔 붙인 것</strong>이었다. <code>@RestController</code>, <code>@Repository</code>도 안쪽에 <code>@Component</code>를 갖고 있다. 이름을 다르게 붙여서 코드를 읽을 때 역할이 바로 보이게 한 것이다.</p>

<hr />

<h2 id="-인터페이스-자리에는-구현체를-찾아서-넣는다">③ 인터페이스 자리에는 구현체를 찾아서 넣는다</h2>

<p><code>FindFeatureFlag</code>는 인터페이스라 <code>new</code> 할 수 없다. Spring은 “<code>FindFeatureFlag</code>를 <code>implements</code> 한 Bean이 있나?” 하고 찾는다.</p>

<pre><code>@Repository
public class FeatureFlagRepository implements LoadFeatureFlag, FindFeatureFlag, ExistFeatureFlag
</code></pre>

<p>하나 찾았으니 이걸 넣는다. 서버가 켜질 때의 조립 순서를 그려 보면 이렇다.</p>

<pre><code>FeatureFlagJpaRepository     (JPA가 자동 생성)
        ↓ 주입
FeatureFlagRepository        (@Repository) ── FindFeatureFlag 자리에 들어감
        ↓ 주입
DeleteFeatureFlag            (@UseCase)
        ↓ 주입
FeatureFlagController        (@RestController)
</code></pre>

<p><code>DeleteFeatureFlag</code> 코드에는 <code>FeatureFlagRepository</code>라는 이름이 한 번도 나오지 않는다. 그런데도 동작한다. 이게 “UseCase는 DB를 모른다”가 실제로 구현되는 방식이다. 그리고 Java는 <code>implements</code>를 명시해야 그 타입으로 인정하기 때문에(명목적 타이핑), Spring이 구현체를 정확히 찾을 수 있다.</p>

<h3 id="프론트로-비유하면">프론트로 비유하면</h3>

<pre><code>// Spring이 서버 시작 시 해주는 일을 직접 쓴다면
const repo = new FeatureFlagRepository(jpa);
const deleteUseCase = new DeleteFeatureFlag(userService, repo, ...);
const controller = new FeatureFlagController(..., deleteUseCase);
</code></pre>

<p>이 조립 코드를 사람이 쓰지 않고 Spring이 자동으로 해준다. React의 Context Provider로 의존성을 내려주는 것과 비슷한데, 클래스가 수천 개라서 손으로 조립하는 건 사실상 불가능하다.</p>

<hr />

<h2 id="만약-repository를-지우면">만약 @Repository를 지우면?</h2>

<p><code>FeatureFlagRepository</code>에서 <code>@Repository</code>를 지우면, Spring은 이 클래스를 관리해야 하는지 자체를 모르게 된다. 그러면:</p>

<pre><code>FeatureFlagRepository     ❌ Bean 아님 (아무도 안 만듦)
        ↓
DeleteFeatureFlag         "FindFeatureFlag 넣어줘" → 구현한 Bean이 없음 → 💥
</code></pre>

<pre><code>***************************
APPLICATION FAILED TO START
***************************
Parameter 1 of constructor in ...DeleteFeatureFlag required a bean of type
'...FindFeatureFlag' that could not be found.
</code></pre>

<p><strong>API 하나만 안 되는 게 아니라 서버 전체가 켜지지 않는다.</strong> 런타임에 null로 터지는 대신 시작 시점에 바로 실패하는 게 DI의 장점이다. 프론트로 치면 런타임 <code>undefined is not a function</code> 대신 빌드 에러로 잡히는 셈이다.</p>

<p>이 에러를 보면 <strong>어노테이션이 빠졌거나, 구현체가 없구나</strong>를 먼저 의심하면 된다.</p>

<hr />

<h2 id="-bean은-서버-전체에서-하나-싱글톤">④ Bean은 서버 전체에서 하나 (싱글톤)</h2>

<p>이번 공부에서 가장 중요하다고 느낀 부분이다.</p>

<p>Spring은 각 Bean을 <strong>딱 한 번만</strong> 만든다. 사용자 100명이 동시에 삭제 요청을 보내도 <code>DeleteFeatureFlag</code> 객체는 하나고, 100개의 요청이 동시에 그 객체의 <code>execute()</code>를 호출한다.</p>

<h3 id="이렇게-쓰면-안-된다">이렇게 쓰면 안 된다</h3>

<pre><code>private Long currentUserId;   // ❌ Bean의 필드에 요청 데이터 저장

public void execute(DeleteFeatureFlagCommand command) {
    this.currentUserId = command.getUserId();
    ...
    featureFlag.delete(this.currentUserId);
}
</code></pre>

<blockquote data-ke-style="style1">
  <p>처음 이 퀴즈를 받았을 때는 “delete에 userId를 넘기는 게 맞나?”를 묻는 줄 알았다. <code>delete(userId)</code>가 userId를 받는 건 맞다. 누가 삭제했는지 기록(<code>updatedBy</code>)하기 위해서다. 문제는 그게 아니라 <strong>userId를 필드에 저장했다는 것</strong>이었다.</p>
</blockquote>

<p>사용자 A와 B가 거의 동시에 삭제를 누르면:</p>

<pre><code>시간 →     DeleteFeatureFlag 객체 (서버에 1개뿐, 둘이 공유)
           currentUserId 필드

A 요청:    currentUserId = A
B 요청:                    currentUserId = B   ← A의 값을 덮어씀
A 요청:                                        delete(currentUserId) → B로 기록됨 ❌
B 요청:                                        delete(currentUserId) → B
</code></pre>

<p>A가 지웠는데 DB에는 <strong>B가 지운 것으로</strong> 남는다. 에러도 나지 않고, 동시에 요청이 와야만 생겨서 테스트에서도 거의 재현되지 않는다. 이런 문제를 <strong>동시성 문제(race condition)</strong> 라고 한다.</p>

<p>프론트 코드로 바꾸면 이런 상황이다.</p>

<pre><code>let currentUserId: number;   // 모듈 최상단 변수 = 모두가 공유

export async function deleteFlag(userId: number) {
  currentUserId = userId;
  await something();          // 이 사이에 다른 호출이 currentUserId를 바꿈
  save(currentUserId);
}
</code></pre>

<p>브라우저는 사용자 한 명이 쓰니까 이런 문제가 거의 없다. 하지만 서버는 <strong>한 프로세스가 수많은 사용자의 요청을 동시에 처리한다.</strong> 프론트에서 백엔드로 넘어오면서 가장 크게 바꿔야 하는 감각이 이거라고 느꼈다.</p>

<h3 id="올바른-방식">올바른 방식</h3>

<pre><code>public void execute(DeleteFeatureFlagCommand command) {
    Long userId = command.getUserId();   // 지역 변수 = 이 요청에서만 존재
    ...
    featureFlag.delete(userId);
}
</code></pre>

<p>메서드 안의 지역 변수는 호출할 때마다 새로 생기기 때문에 다른 요청과 섞이지 않는다.</p>

<blockquote data-ke-style="style1">
  <p><strong>규칙: Bean(<code>@UseCase</code>, <code>@Repository</code>, <code>@RestController</code>)의 필드에는 다른 Bean만 넣고, 요청 데이터는 항상 파라미터나 지역 변수로 다룬다.</strong></p>
</blockquote>

<hr />

<h2 id="정리">정리</h2>

<table data-ke-align="alignLeft">
  <thead>
    <tr>
      <th>코드</th>
      <th>Spring에게 하는 말</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td><code>@Component</code> / <code>@UseCase</code> / <code>@Repository</code> / <code>@RestController</code></td>
      <td>“이 클래스는 네가 만들어서 관리해줘”</td>
    </tr>
    <tr>
      <td><code>private final X x;</code> + <code>@RequiredArgsConstructor</code></td>
      <td>“나를 만들 때 X를 넣어줘”</td>
    </tr>
    <tr>
      <td><code>implements X</code></td>
      <td>“X가 필요한 곳에 나를 넣어도 돼”</td>
    </tr>
  </tbody>
</table>

<p>다음 글에서는 메서드 이름만 써도 SQL이 만들어지는 <a href="/OHaEuN/26"><strong>JPA</strong></a>를 정리한다.</p>]]></content><author><name>OHaEuN</name></author><category term="Back-end" /><category term="백엔드 입문" /><category term="Spring" /><category term="의존성 주입" /><category term="Bean" /><summary type="html"><![CDATA[지난 글에서 Java 문법을 정리하면서 계속 마음에 걸리는 코드가 있었다. final 필드는 생성자에서 반드시 값을 넣어야 한다. 그런데 생성자도 없고, new DeleteFeatureFlag(...)를 부르는 곳도 없다. 그런데도 null이 아니다. 이 두 가지를 각각 다른…]]></summary><media:thumbnail xmlns:media="http://search.yahoo.com/mrss/" url="https://ohaeun.github.io/OHaEuN/assets/posts/24/thumbnail.jpg" /><media:content medium="image" url="https://ohaeun.github.io/OHaEuN/assets/posts/24/thumbnail.jpg" xmlns:media="http://search.yahoo.com/mrss/" /></entry></feed>